Bit Twiddling, Duff's Device ...
Les optimisations extrêmes de code
ET SI JE VOUS DISAIS ...
Juste comme ça ...
DANS LES ANNÉES 80/90
Un peu d'histoire
Les CPU sont poussifs, la mémoire est lente et limitée
Les compilateurs sont encore peu avancés et peu optimisants
Le dialogue avec les périphériques est lent
Instructions d'entrées-sorties (in/out) ou registres mappés en mémoire (MMIO)
Chaque instruction est décortiquée
Chaque cycle CPU est compté, chaque octet de mémoire est analysé
Naissance de techniques d'optimisation
Dont certaines sont assez folles
MAINTENANT IMAGINEZ ...
Qu'il est possible d'optimiser certaines opérations
sans aucune condition, aucun branchement, aucune boucle
Que de simples nombres et opérations logiques
cachent parfois des secrets insoupçonnés
Qu'un bout de code écrit en 1983 chez Lucasfilm continue
de fasciner des générations de développeurs
···
Bienvenue dans le monde
des optimisations extrêmes !
Et parfois un peu WTF !
C'EST QUOI L'OPTIMISATION ?
Une petite parenthèse
L'OPTIMISATION
C'est Dan Ariely qui en parle le mieux
C'est comme le sexe chez les adolescents : tout le monde en parle, personne ne sait vraiment comment s'y prendre, tout le monde pense que les autres le font, donc tout le monde prétend le faire
Dan Ariely, à propos du big data (2013)
POURQUOI ET QUOI OPTIMISER ?
C'est d'abord une question de bon sens
Certaines architectures sont parfois contraintes
Microcontrôleurs 8/16/32 bits, environnement peu puissant, peu de mémoire, ...
Certaines portions de code sont exécutées des milliers de fois chaque seconde
C'est le code chaud : boucles critiques, noyaux d'OS, émulateurs, traitement d'images, ...
Et surtout ...
On n'optimise pas par conviction ou pour se faire plaisir !
Il faut mesurer, toujours mesurer !
L'OPTIMISATION DE CODE
Il existe deux formes bien distinctes
L'OPTIMISATION ALGORITHMIQUE
Le premier réflexe conditionné à avoir
L'OPTIMISATION TECHNIQUE
Quand il n'y a plus d'autre espoir
L'OPTIMISATION ALGORITHMIQUE
Diminuer le nombre d'opérations
Choisir un bon algorithme pour réduire la complexité
en Notation Big O : O(n!) → O(n²) → O(n log n) → O(n) → O(1)
Choisir une bonne structure de données
Ex. utiliser une table de hachage plutôt qu'une recherche linéaire
Indépendante du langage et du matériel
Les gains se comptent en ordres de grandeur
Elle prime toujours sur le reste
Aucune autre optimisation ne rattrapera un mauvais choix algorithmique
L'OPTIMISATION TECHNIQUE
Faire plus avec le même budget
Garder le même algorithme, mais l'exécuter avec moins de cycles
Moins d'instructions, moins de branchements, moins d'octets, ...
Effectuer plus de travail utile par cycle machine
Rentabiliser le pipeline d'instructions, gérer l'alignement mémoire, profiter du parallélisme, ...
Réduire le coût caché des constructions courantes
un test et un branchement par tour de boucle doublent le nombre d'opérations pour une copie
Tenir compte de la micro-architecture
pipeline superscalaire, prédiction de branchement, cache d'instructions, ...
L'OPTIMISATION
Le conseil de Donald Knuth
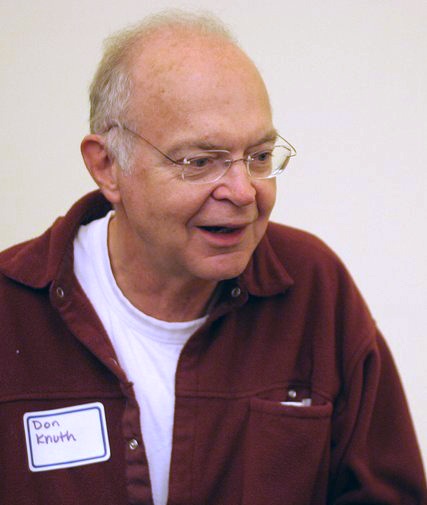
On devrait oublier les petits gains d'efficacité, disons dans 97% des cas : l'optimisation prématurée est la source de tous les maux.
Donald Knuth, Structured Programming with go to Statements (1974)
Je vais vous parler des 3% restants
Quand on est au bout de sa vie
COMPILER EXPLORER
Ne jamais optimiser sur du ressenti
VOUS ALLEZ VOIR DU CODE
En C et en assembleur
COMPILER EXPLORER
La source de vérité
BIT TWIDDLING
Ces optimisations de code sont extrêmes
C'EST QUOI LE BIT TWIDDLING ?
Manipuler des bits pour arriver à ses fins
Littéralement : la manipulation de bits
Octets, mots, doubles mots, ...
À la frontière des mathématiques et de l'informatique
Opérations logiques combinées aux opérations arithmétiques
L'objectif : des calculs en temps constant
Sans branchement, sans boucle, une exécution linéaire qui nourrit le pipeline
LES OPÉRATEURS BIT À BIT
Ce que tout développeur connaît déjà
| Op. | Nom | [0·0] | [0·1] | [1·0] | [1·1] | Exemple |
|---|---|---|---|---|---|---|
| & | AND | 0 | 0 | 0 | 1 | 0b1100 & 0b1010 = 0b1000 |
| | | IOR | 0 | 1 | 1 | 1 | 0b1100 | 0b1010 = 0b1110 |
| ^ | XOR | 0 | 1 | 1 | 0 | 0b1100 ^ 0b1010 = 0b0110 |
| ~ | NOT | ~0b00001100 = 0b11110011 | ||||
| << | SHL | 0b0011 << 2 = 0b1100 | ||||
| >> | SHR | 0b1100 >> 2 = 0b0011 |
LES OPÉRATEURS BIT À BIT
Tester, positionner, inverser, masquer et comparer
                                bit    = value & (1 << n);  /* tester un bit      */
                                value |=  (1 << n);         /* positionner un bit */
                                value &= ~(1 << n);         /* effacer un bit     */
                                value ^=  (1 << n);         /* inverser un bit    */
                                lsb    = value & 0xff;      /* masquer un octet   */
                                flags  = O_RDWR | O_CREAT;  /* combiner des flags */
                                same   = ((a ^ b) == 0);    /* comparer deux mots */
Avec ces opérateurs de base, on peut tout faire ...
Tout ...
Mais vraiment tout !
DÉCALAGES ET ROTATIONS
Multiplier, diviser, extraire, tourner
                                x * 8   ==  x << 3;                 /* multiplication par 2^n    */
                                x / 8   ==  x >> 3;                 /* division par 2^n          */
                                x * 320 ==  (x << 8) + (x << 6);    /* multiplication arbitraire */
                                byte    = (value >> 8) & 0xff;      /* extraire un champ         */
                                rotl    = (x << n) | (x >> (32-n)); /* rotation à gauche         */
Décalage logique ou arithmétique
>> propage le bit de signe sur un type signé ; JavaScript et Java distinguent >> et >>>
Rotation : pas d'opérateur, mais l'idiome est reconnu par les compilateurs
Instructions rol/ror ; fonctions dédiées ailleurs : std::rotl C++20, rotate_left Rust, Integer.rotateLeft Java
DES BRIQUES À LA COMBINAISON
Le Bit Twiddling commence ici
Ces briques sont simples et connues
Tout développeur les a déjà écrites
Le Bit Twiddling, c'est leur combinaison avec l'arithmétique
Addition, soustraction, complément à 2, pour remplacer tests, branchements et boucles
Méthode pour la suite
Pour chaque problème : la version naïve, la version Bit Twiddling, puis ce que génère réellement le compilateur
ARRONDIR À UNE PUISSANCE DE 2
Le « Hello World » du bit twiddling
                                    /* naïf */
                                    unsigned int round_up_8(unsigned int value)
                                    {
                                        return ((value + 7) / 8) * 8;
                                    }
                                    /* bit twiddling */
                                    unsigned int round_up_8(unsigned int value)
                                    {
                                        return (value + 7) & ~7;
                                    }
value + 7
Pousse la valeur jusqu'au prochain multiple de 8, sauf si elle en est déjà un
& ~7
Le masque inverse efface les 3 bits de poids faible : on retombe sur le multiple de 8
Généralisable à toute puissance de 2
0 → 0, 3 → 8, 8 → 8, 11 → 16 ; + (n-1) & ~(n-1)
ARRONDIR À UNE PUISSANCE DE 2
GCC x86-64 sans optimisation
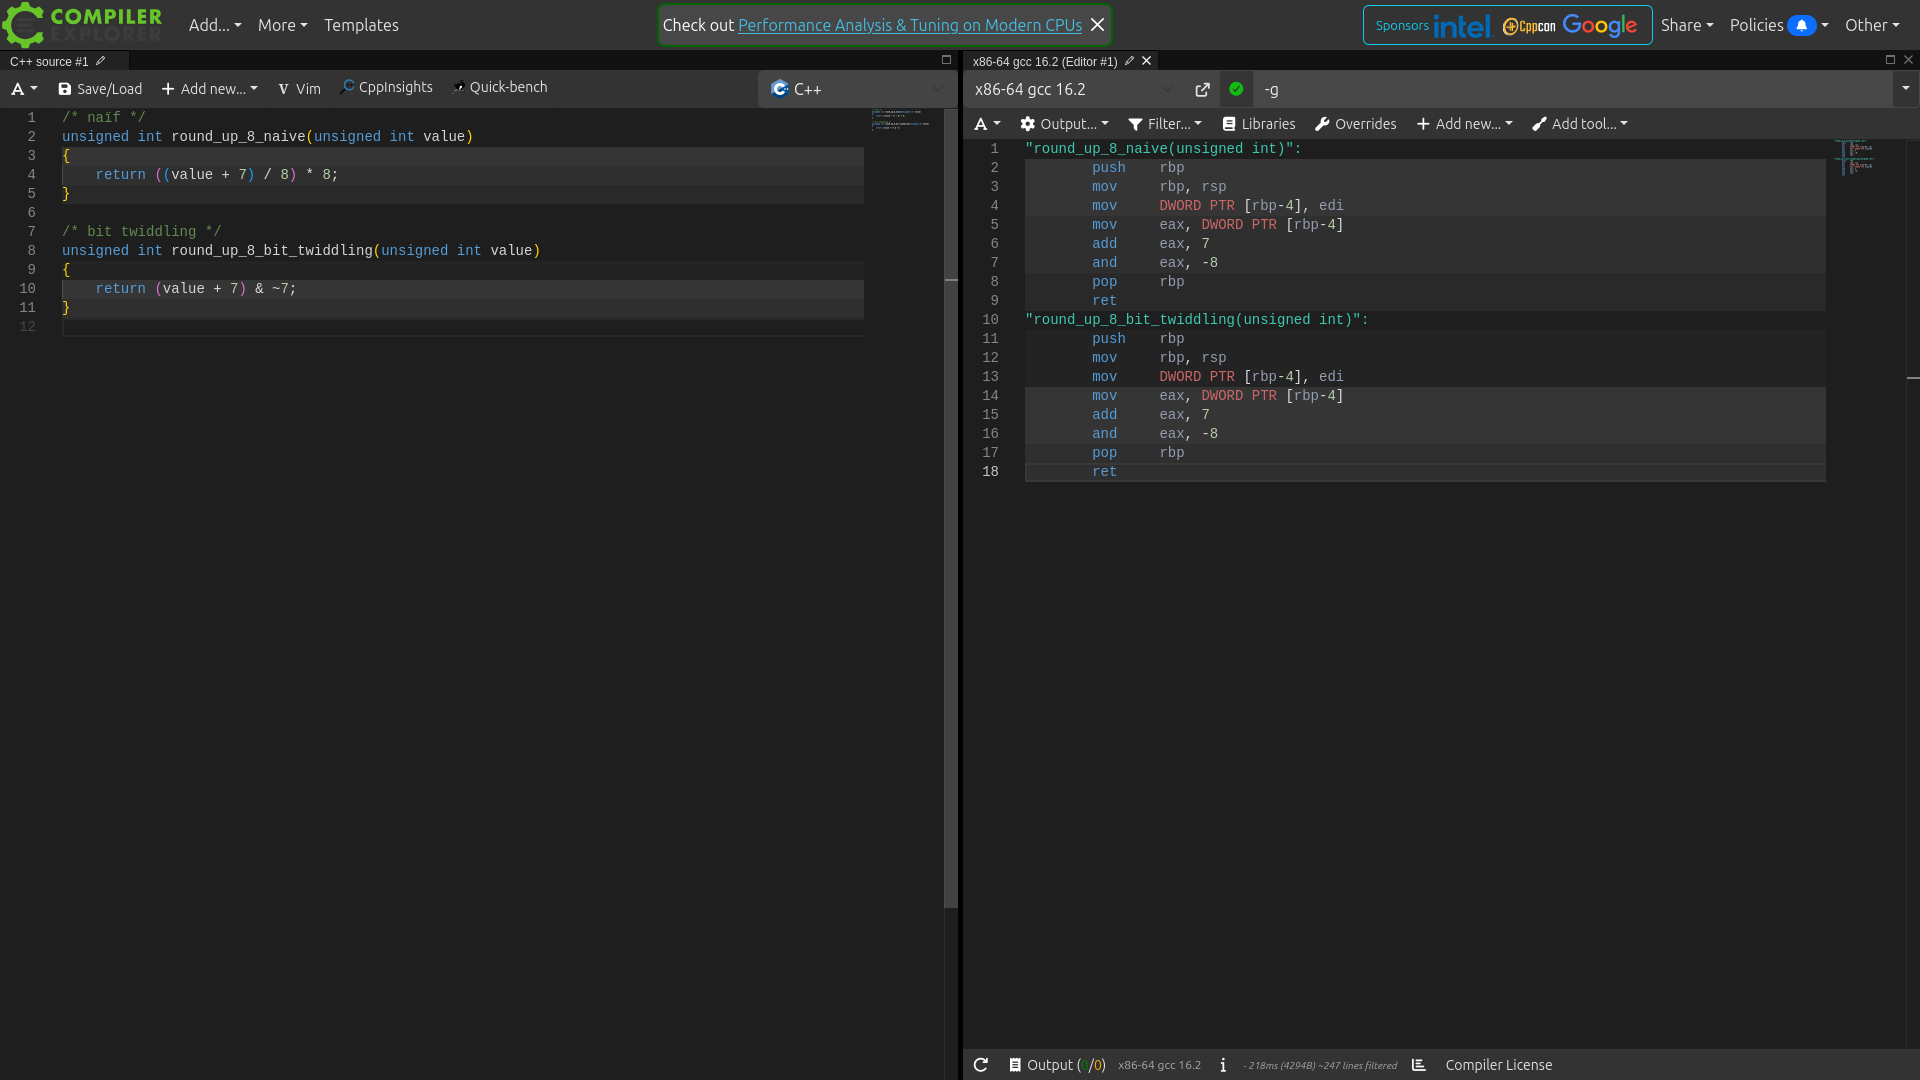
Le code généré est identique
ARRONDIR À UNE PUISSANCE DE 2
Clang x86-64 sans optimisation
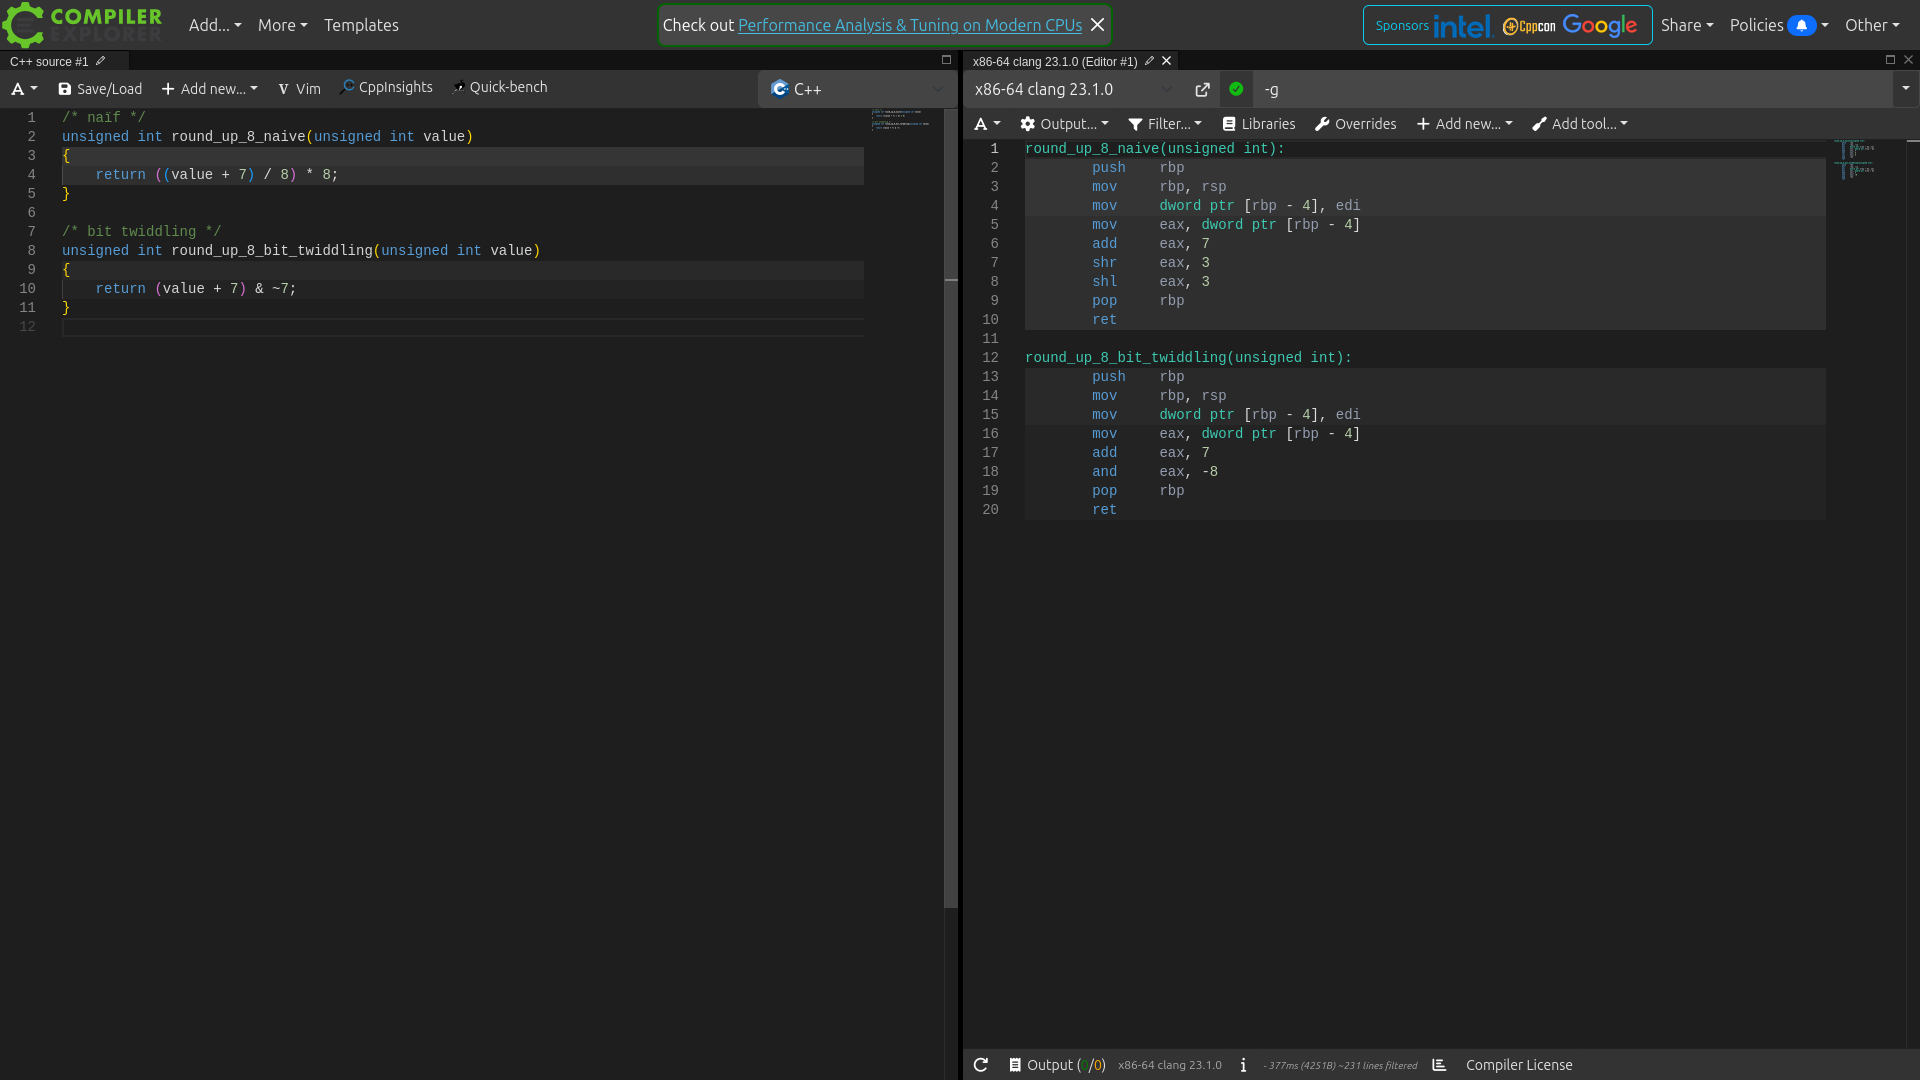
Le code généré est presque équivalent
ARRONDIR À UNE PUISSANCE DE 2
Clang eBPF sans optimisation
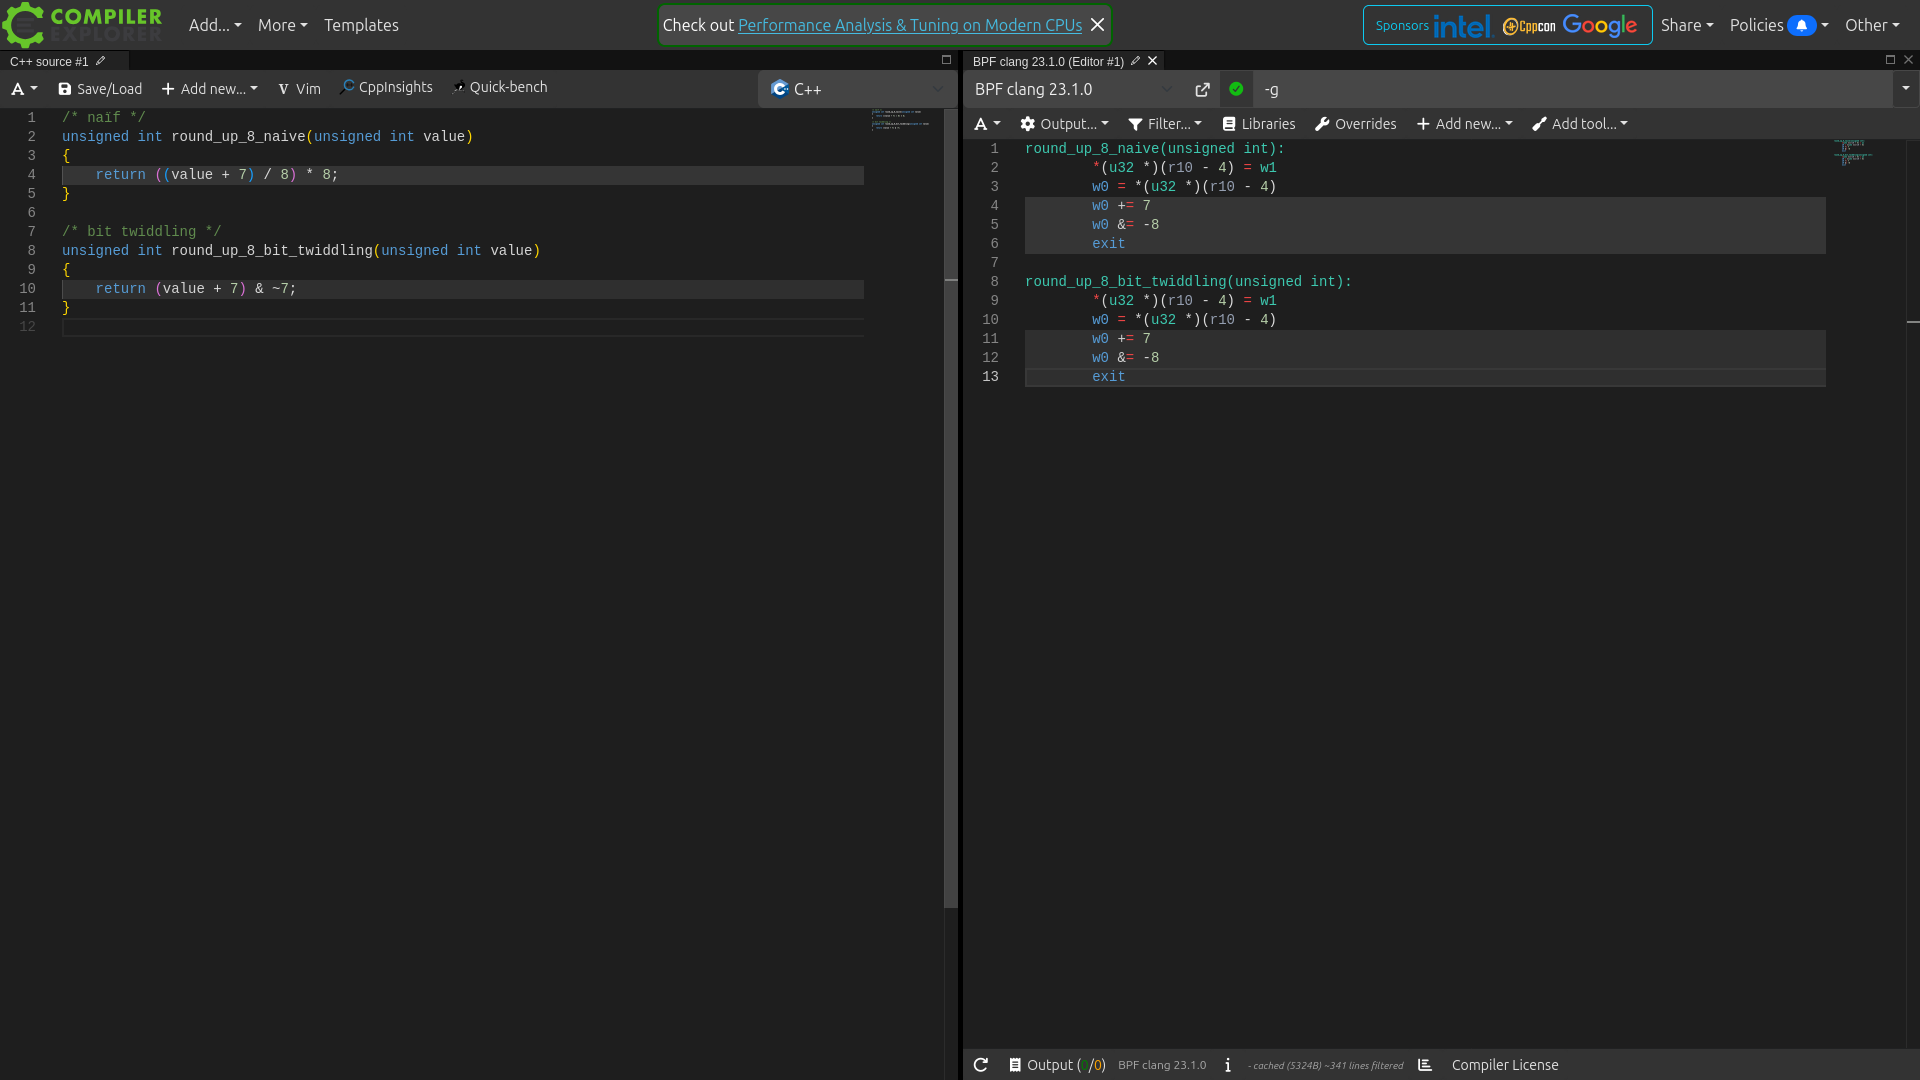
Le code généré est identique
ARRONDIR À UNE PUISSANCE DE 2
Arduino Uno sans optimisation
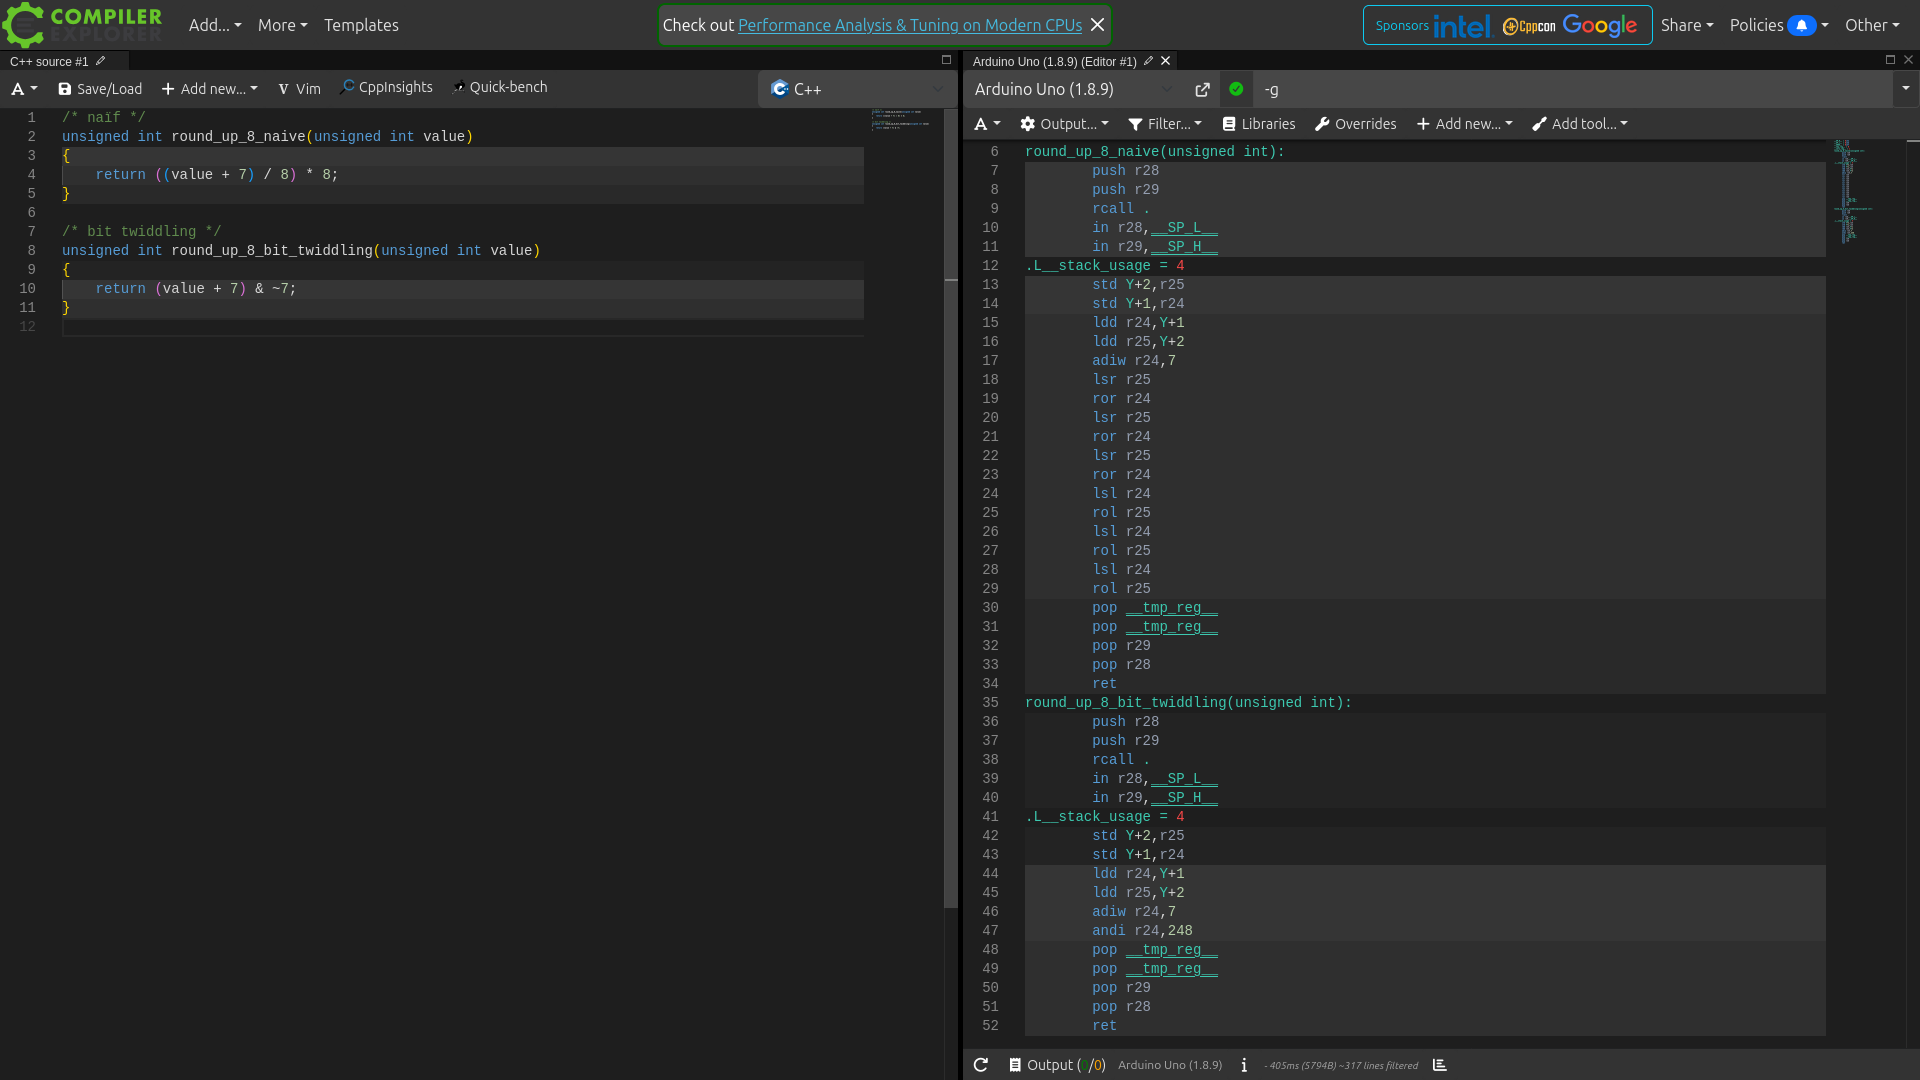
Le code généré est bien meilleur
en version bit twiddling
ARRONDIR À UNE PUISSANCE DE 2
GCC x86-64 avec optimisation
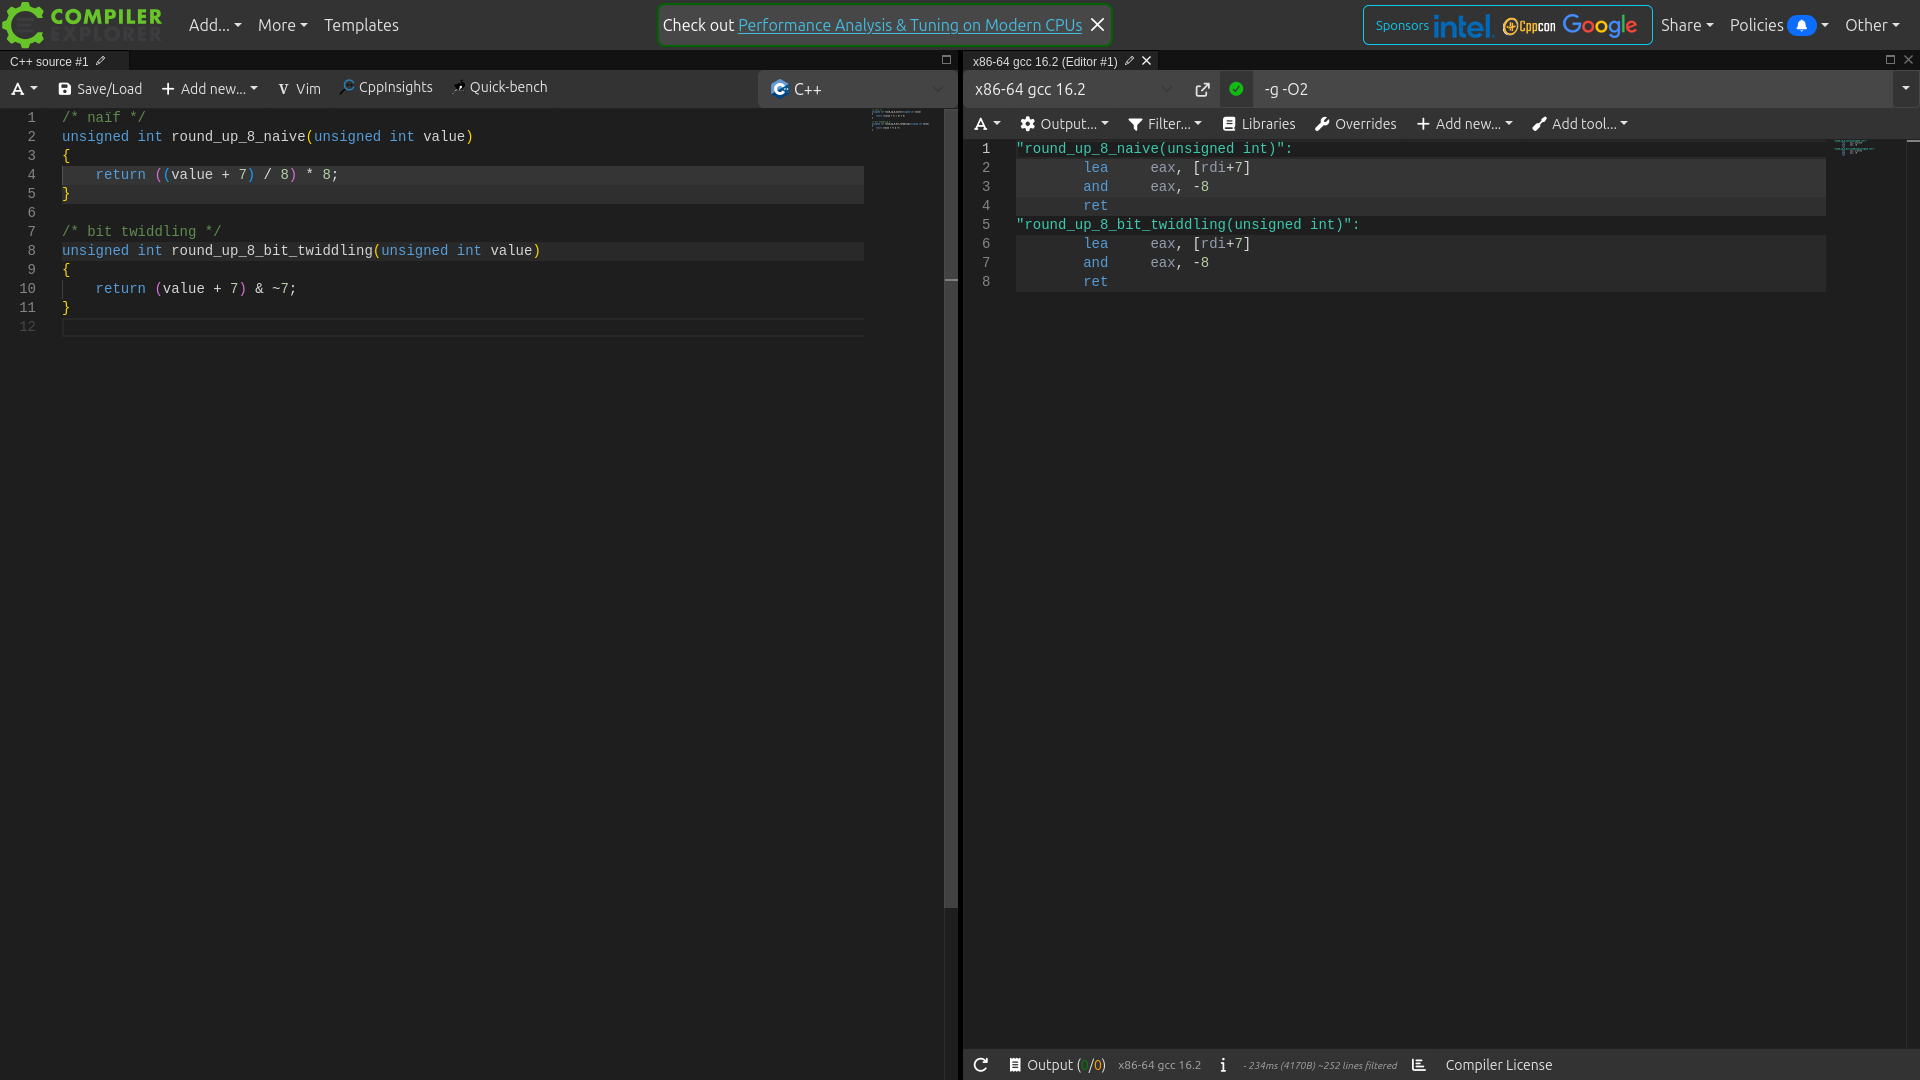
Le code généré est identique
ARRONDIR À UNE PUISSANCE DE 2
Clang x86-64 avec optimisation
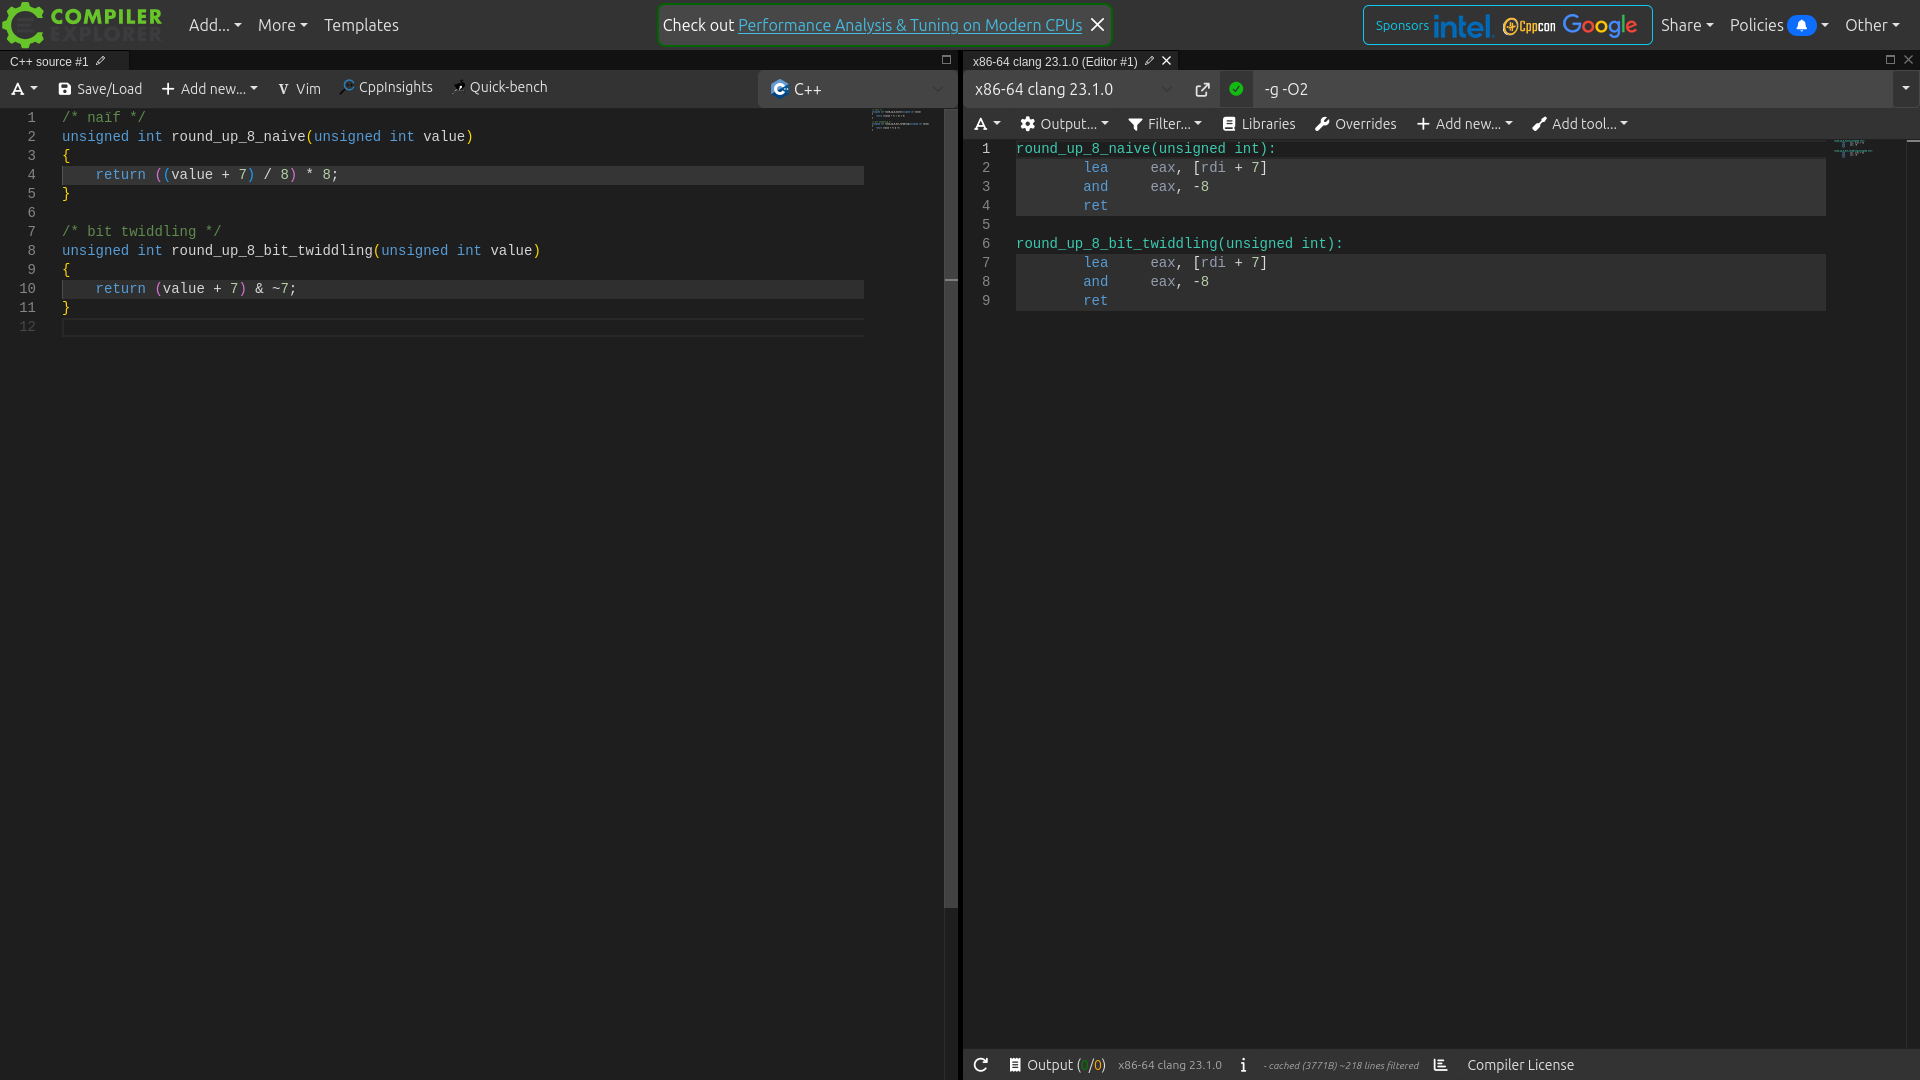
Le code généré est identique
ARRONDIR À UNE PUISSANCE DE 2
Clang eBPF avec optimisation
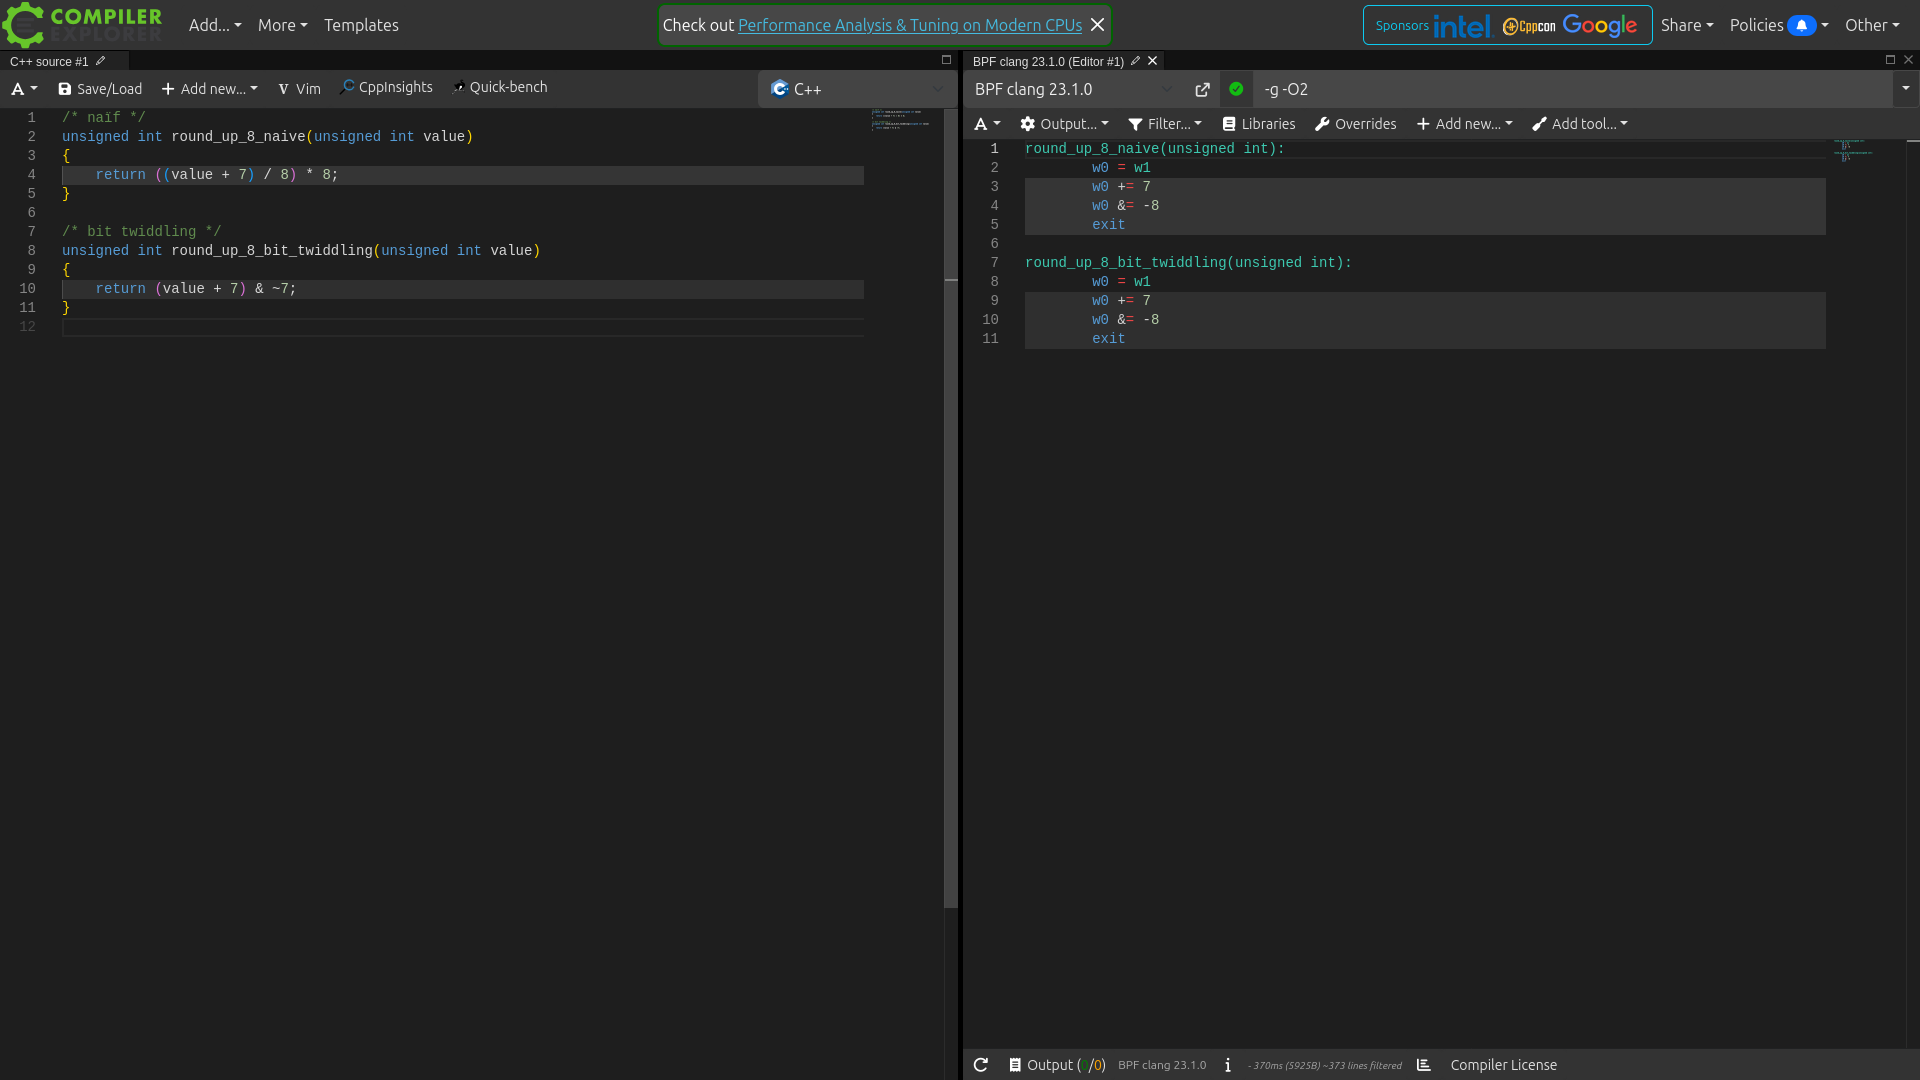
Le code généré est identique
ARRONDIR À UNE PUISSANCE DE 2
Arduino Uno avec optimisation
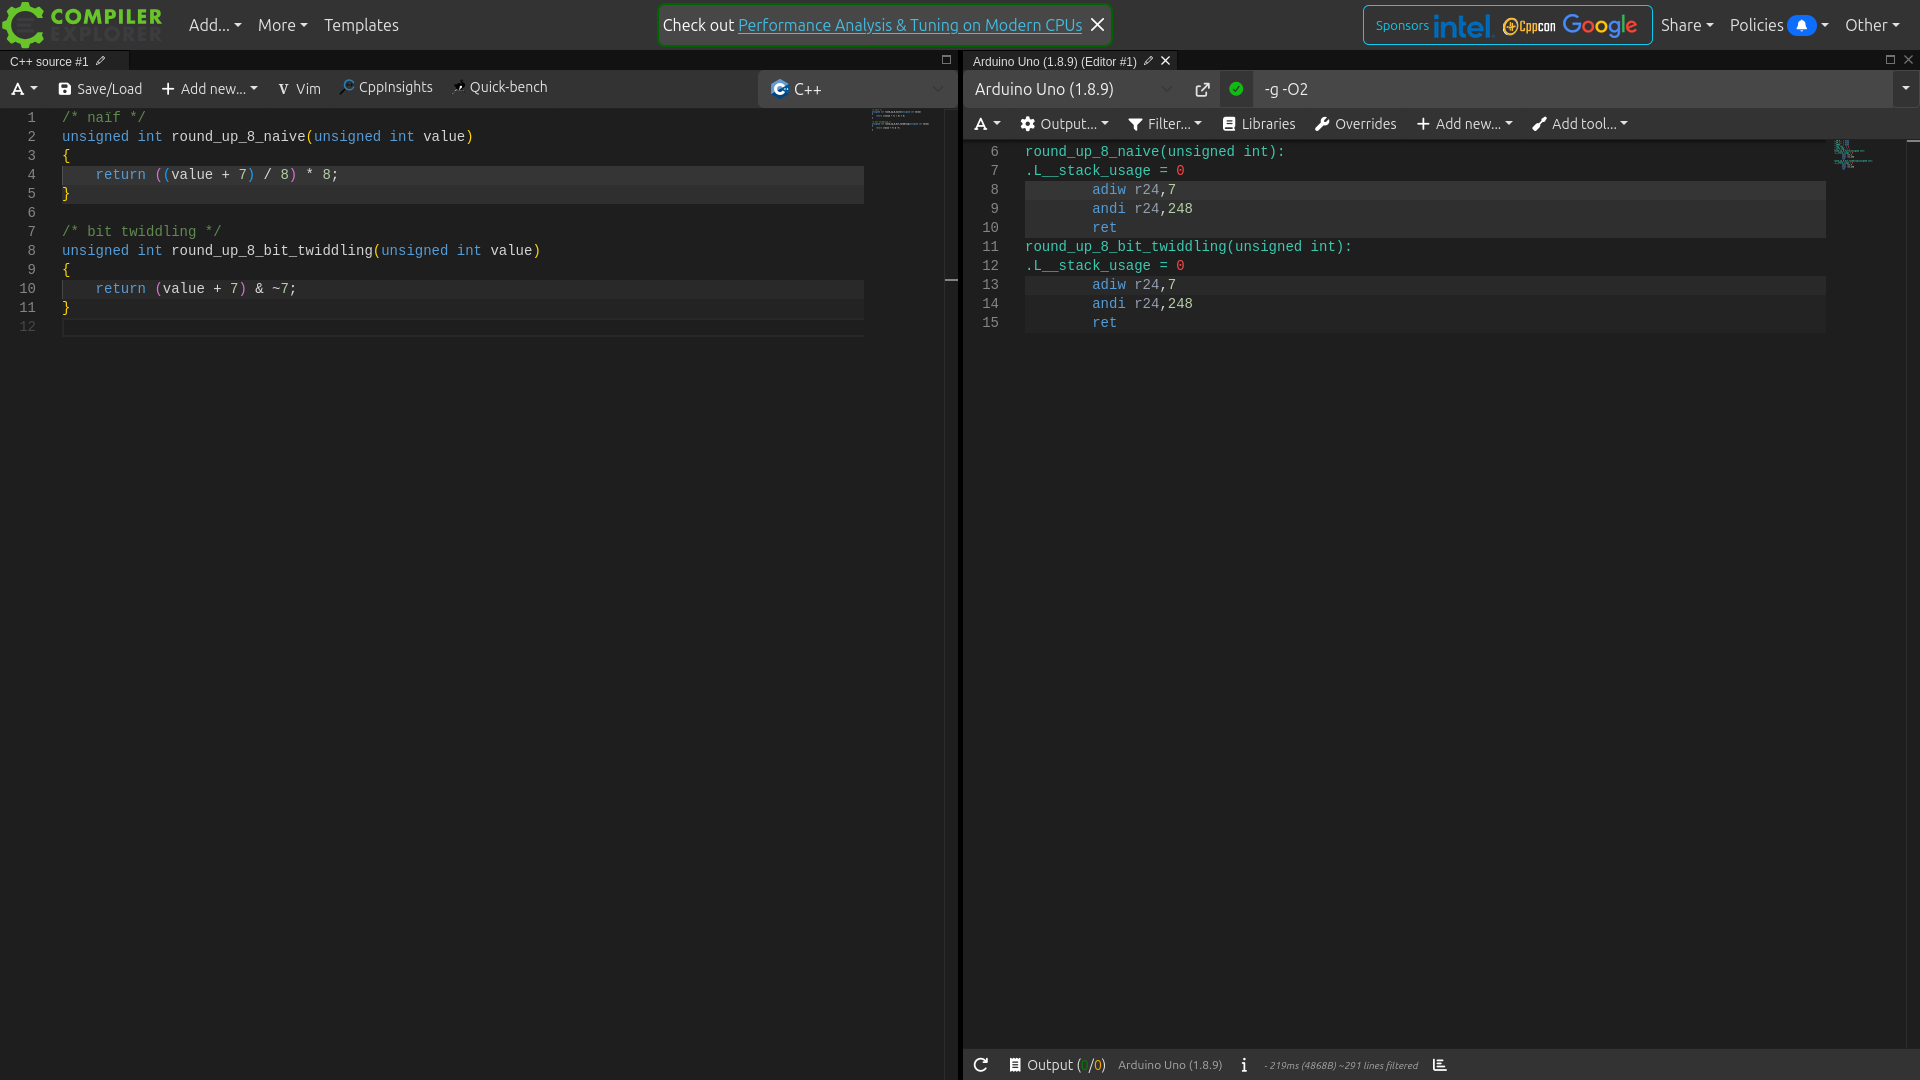
Le code généré est identique
CALCULER UNE VALEUR ABSOLUE
Sans aucun branchement
                                    /* naïf */
                                    int abs(int value)
                                    {
                                        if(value < 0) {
                                            return -value;
                                        }
                                        return value;
                                    }
                                    /* bit twiddling */
                                    int abs(int value)
                                    {
                                        const int mask = value >> 31;
                                        return (value + mask) ^ mask;
                                    }
mask = value >> 31
Le décalage arithmétique recopie le bit de signe : 0 si positif, -1 si négatif
(value + mask) ^ mask
Identité si positif, complément à 2 si négatif
Trois opérations, sans test ni branchement
L'exécution reste linéaire pour le processeur
CALCULER UNE VALEUR ABSOLUE
GCC x86-64 sans optimisation
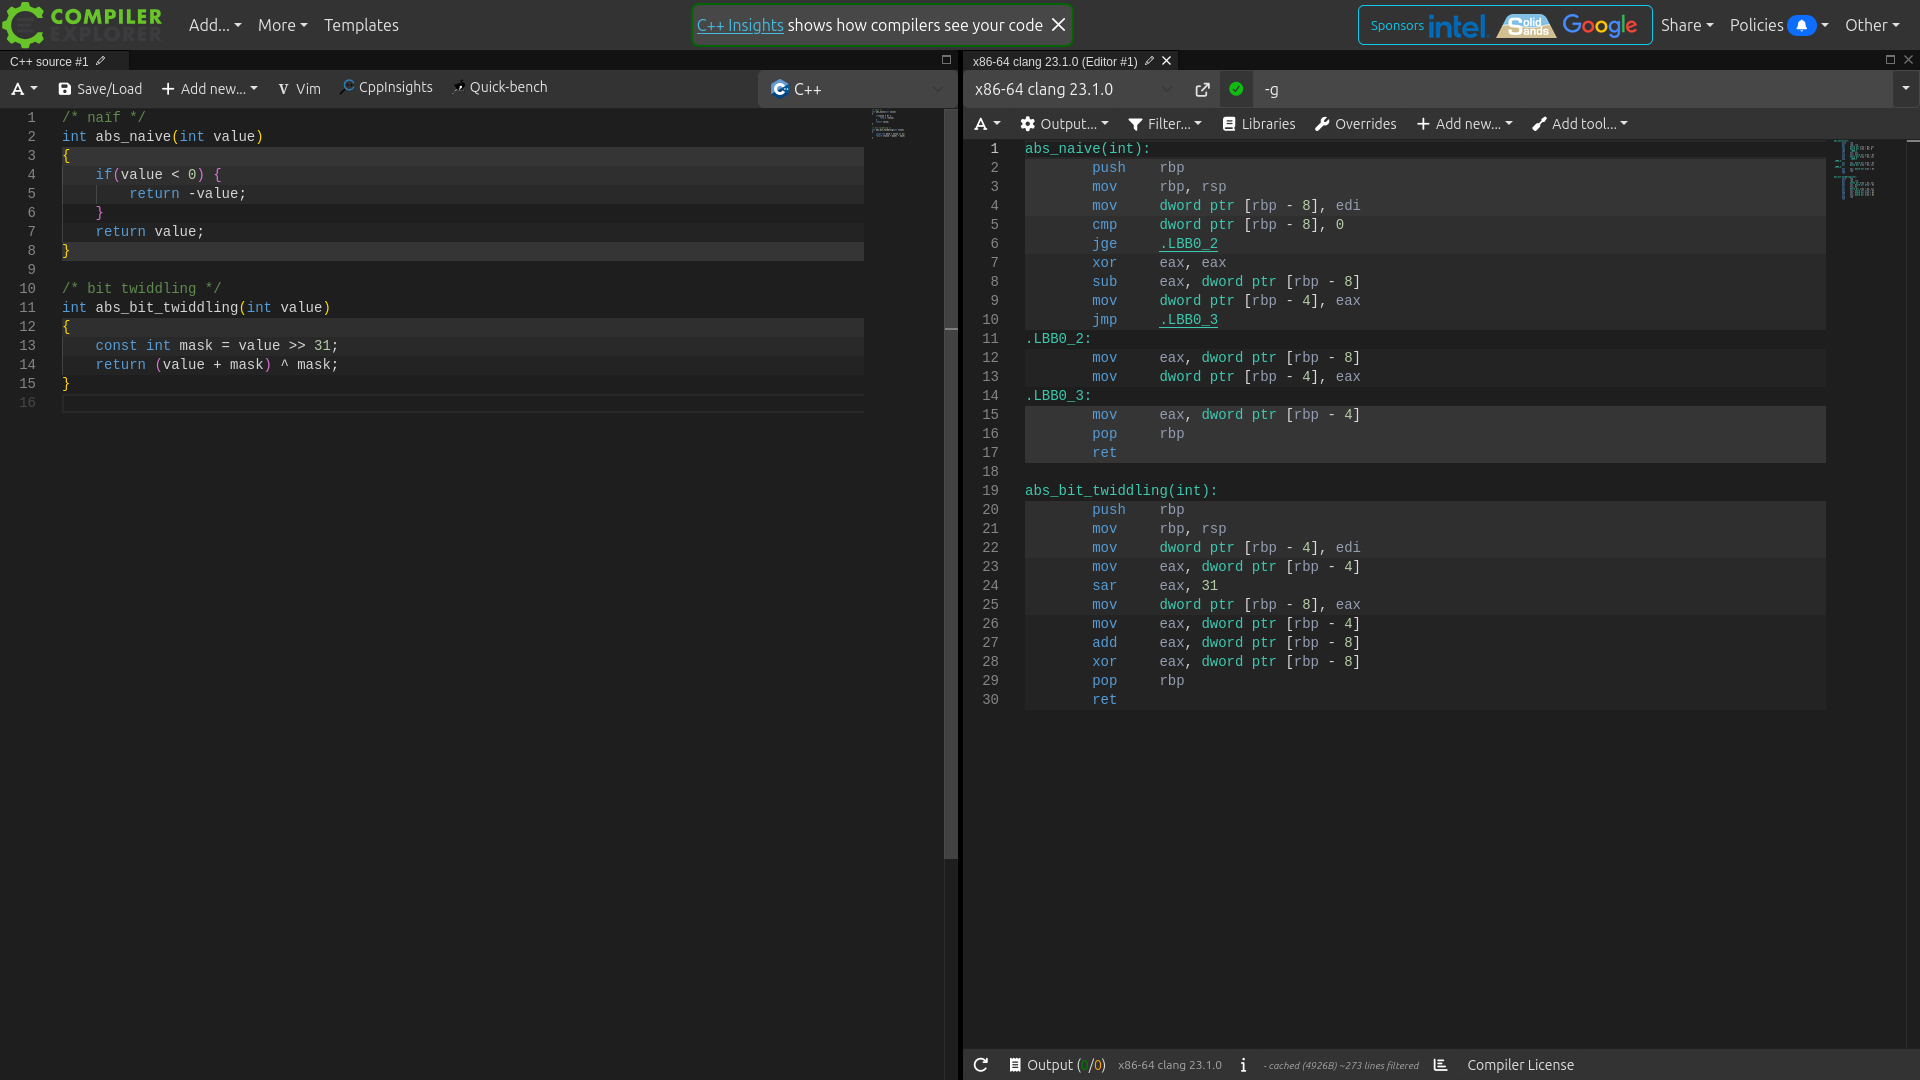
La version bit twiddling est meilleure
CALCULER UNE VALEUR ABSOLUE
Clang x86-64 sans optimisation
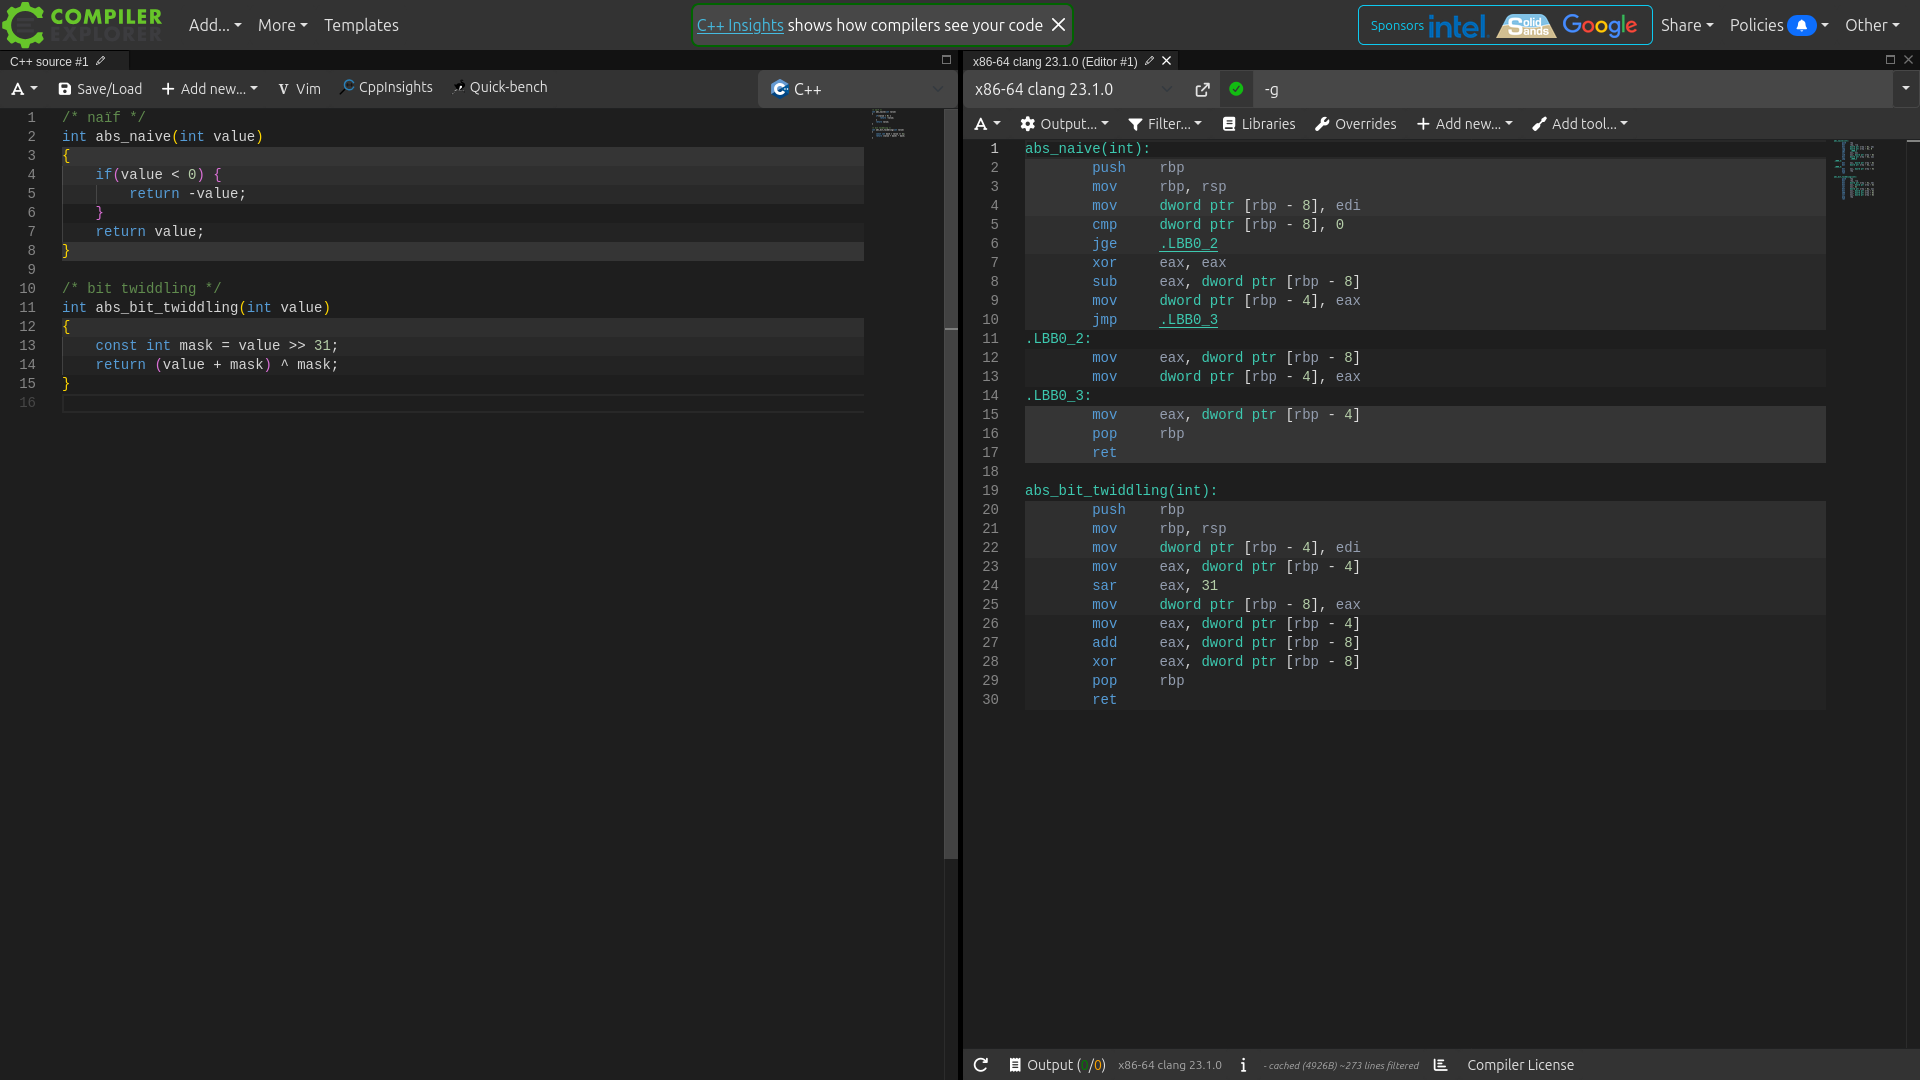
La version bit twiddling est meilleure
CALCULER UNE VALEUR ABSOLUE
Clang eBPF sans optimisation
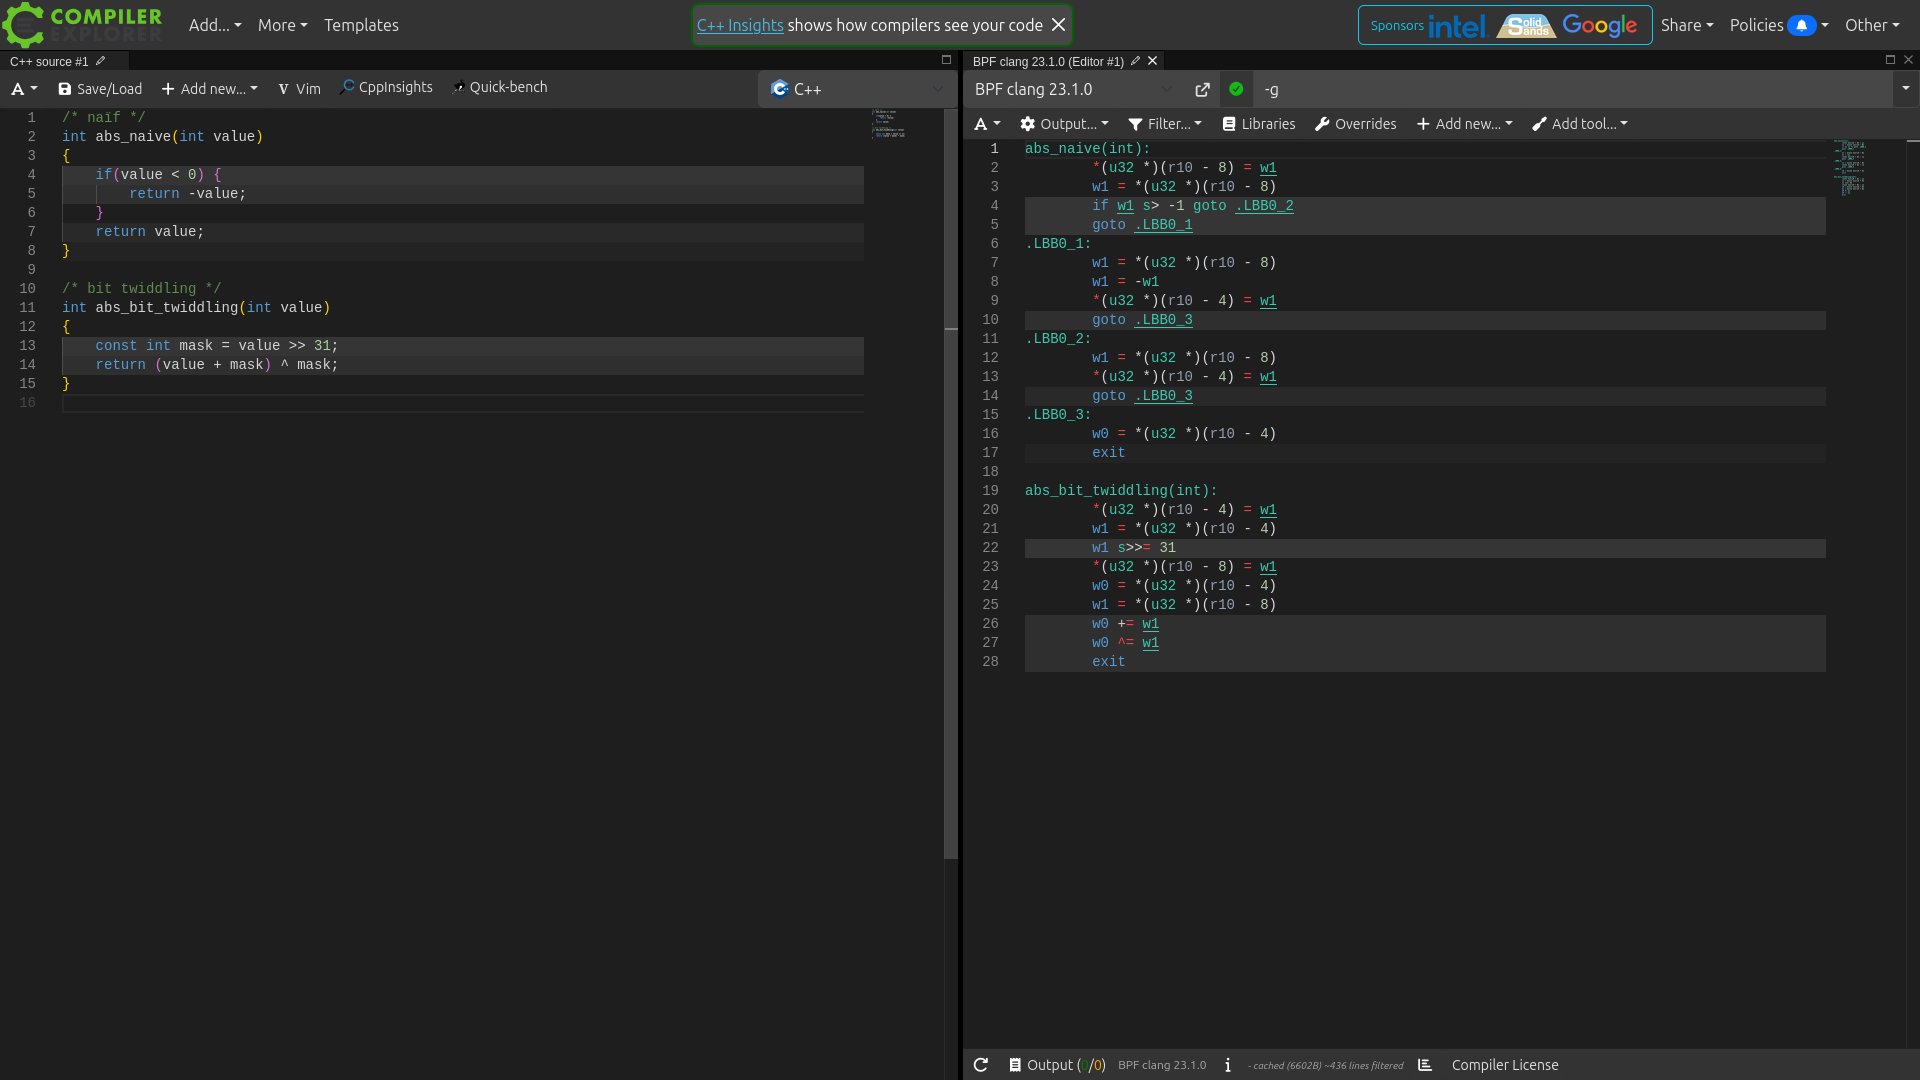
La version bit twiddling est meilleure
CALCULER UNE VALEUR ABSOLUE
GCC x86-64 avec optimisation
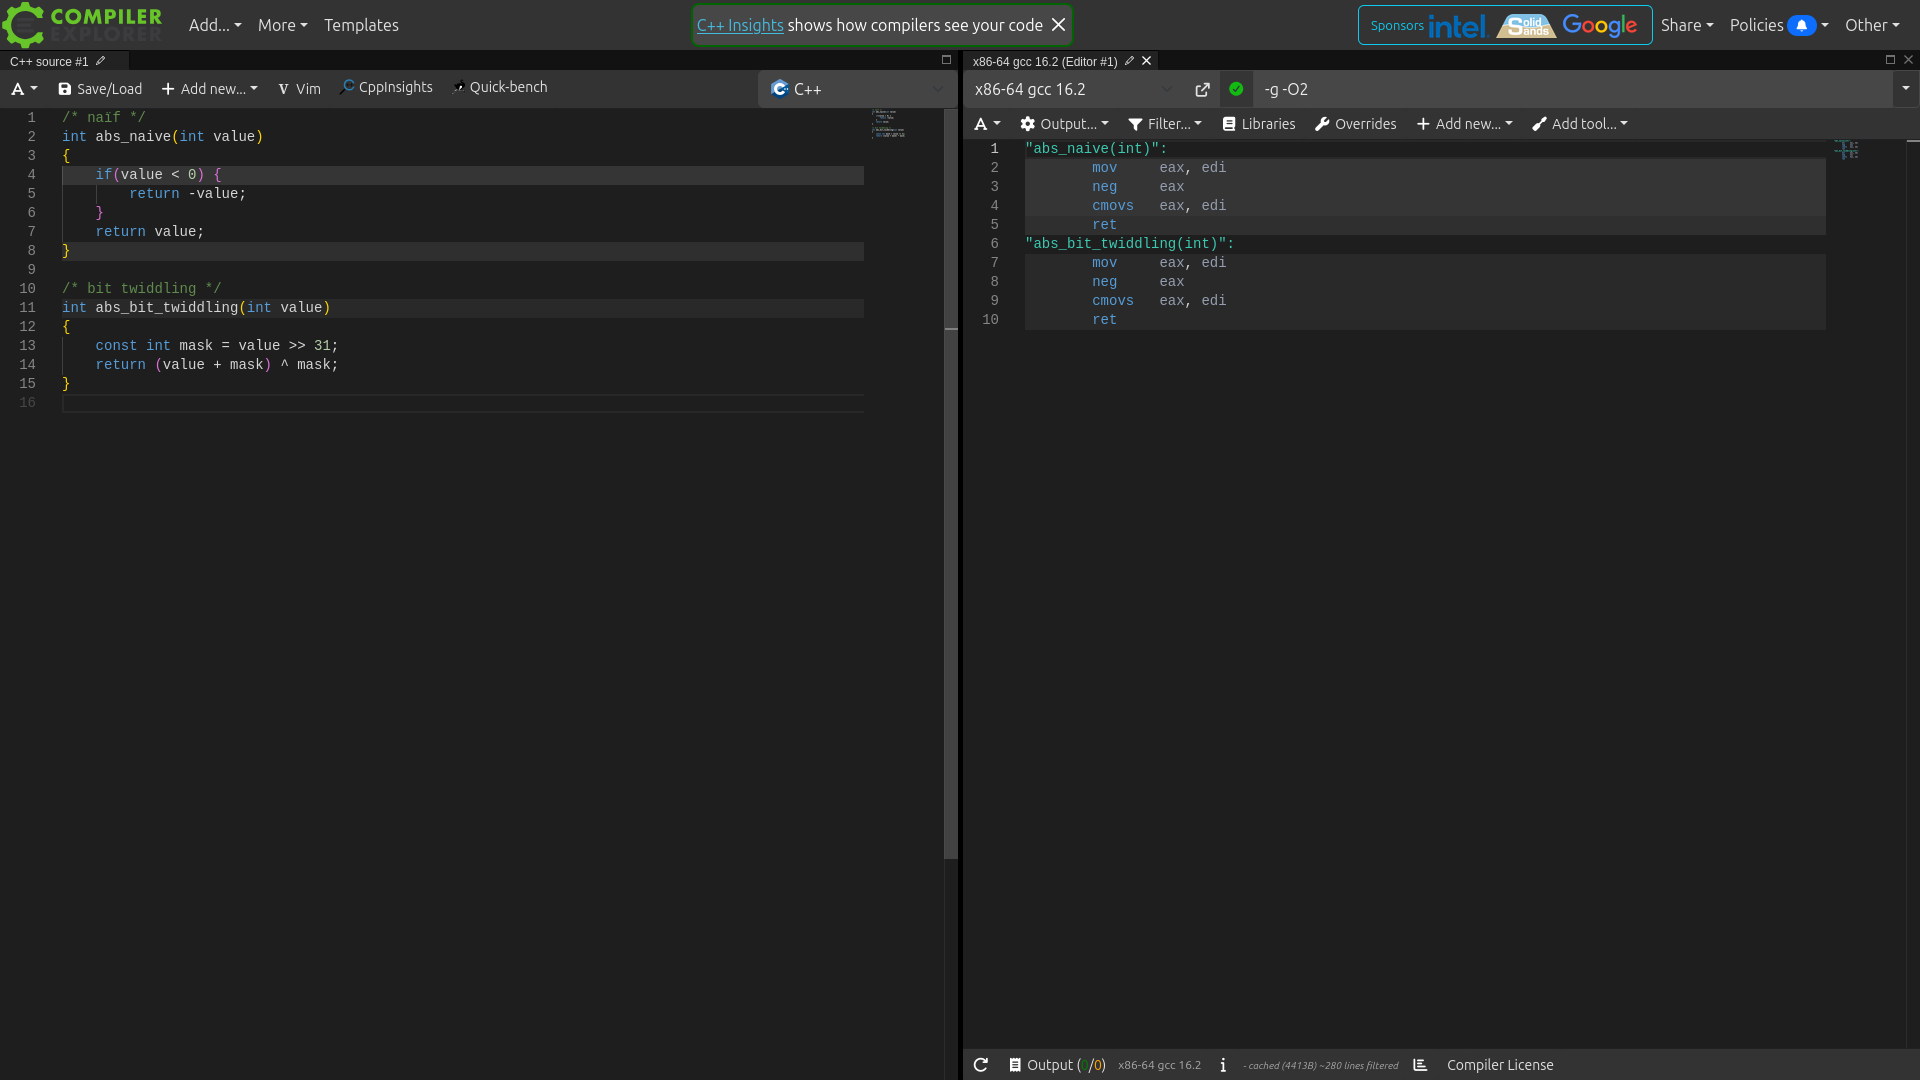
Le code généré est identique
CALCULER UNE VALEUR ABSOLUE
Clang x86-64 avec optimisation
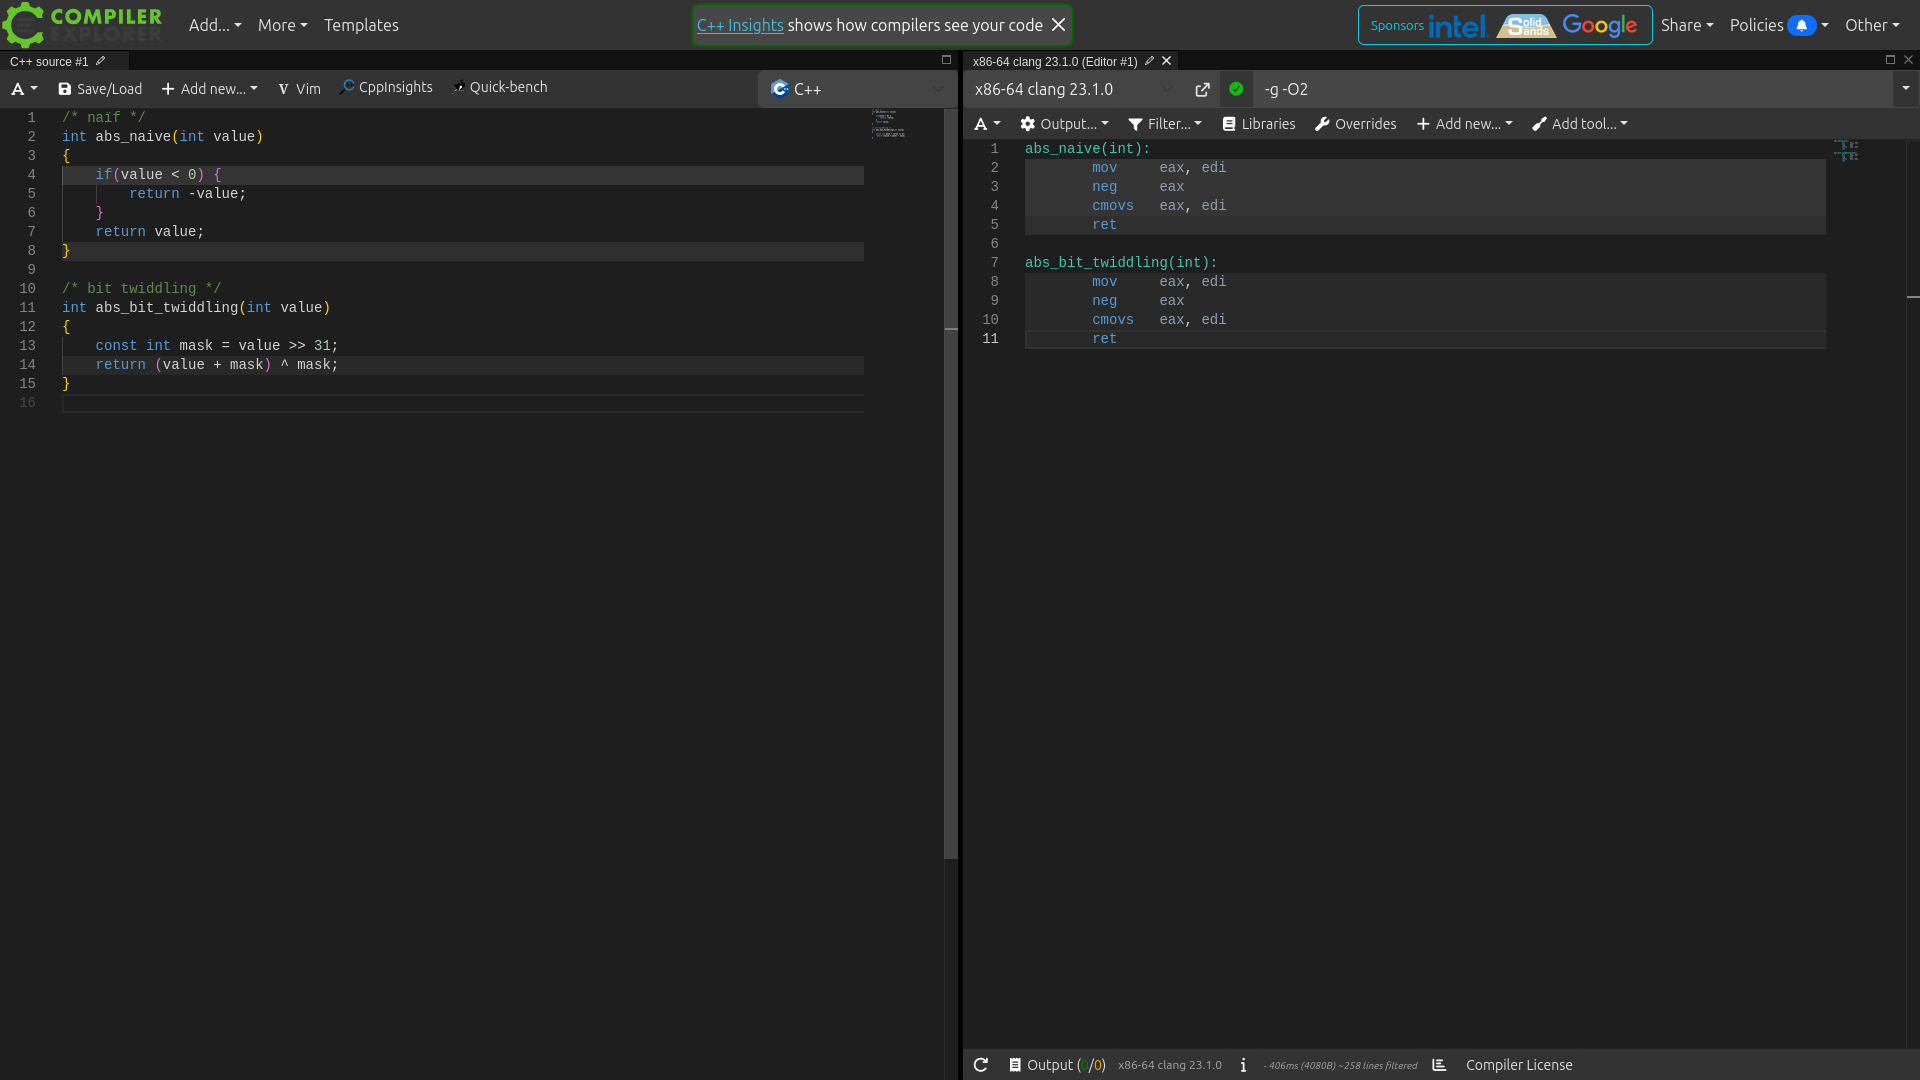
Le code généré est identique
CALCULER UNE VALEUR ABSOLUE
Clang eBPF avec optimisation
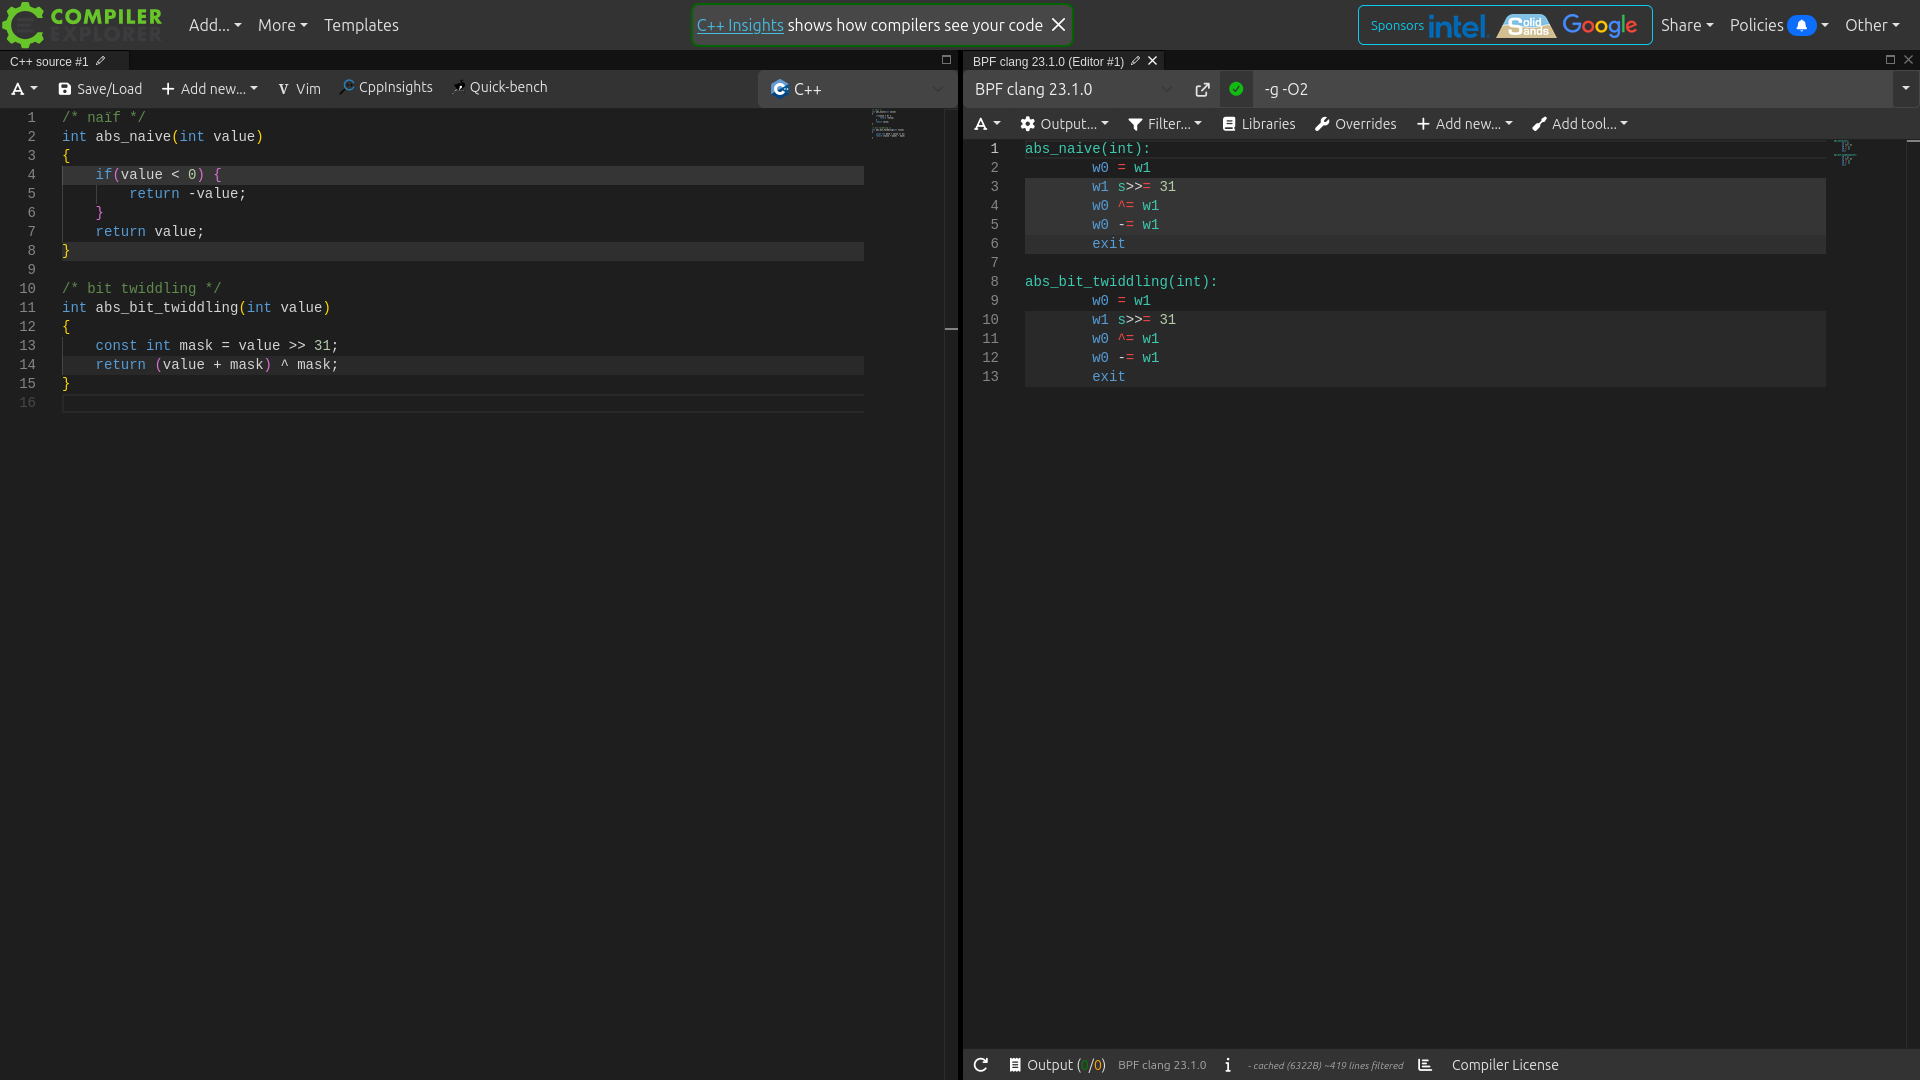
Le code généré est identique
et on retrouve le pattern du bit twiddling
CALCULER UNE VALEUR ABSOLUE
Arduino Uno avec optimisation
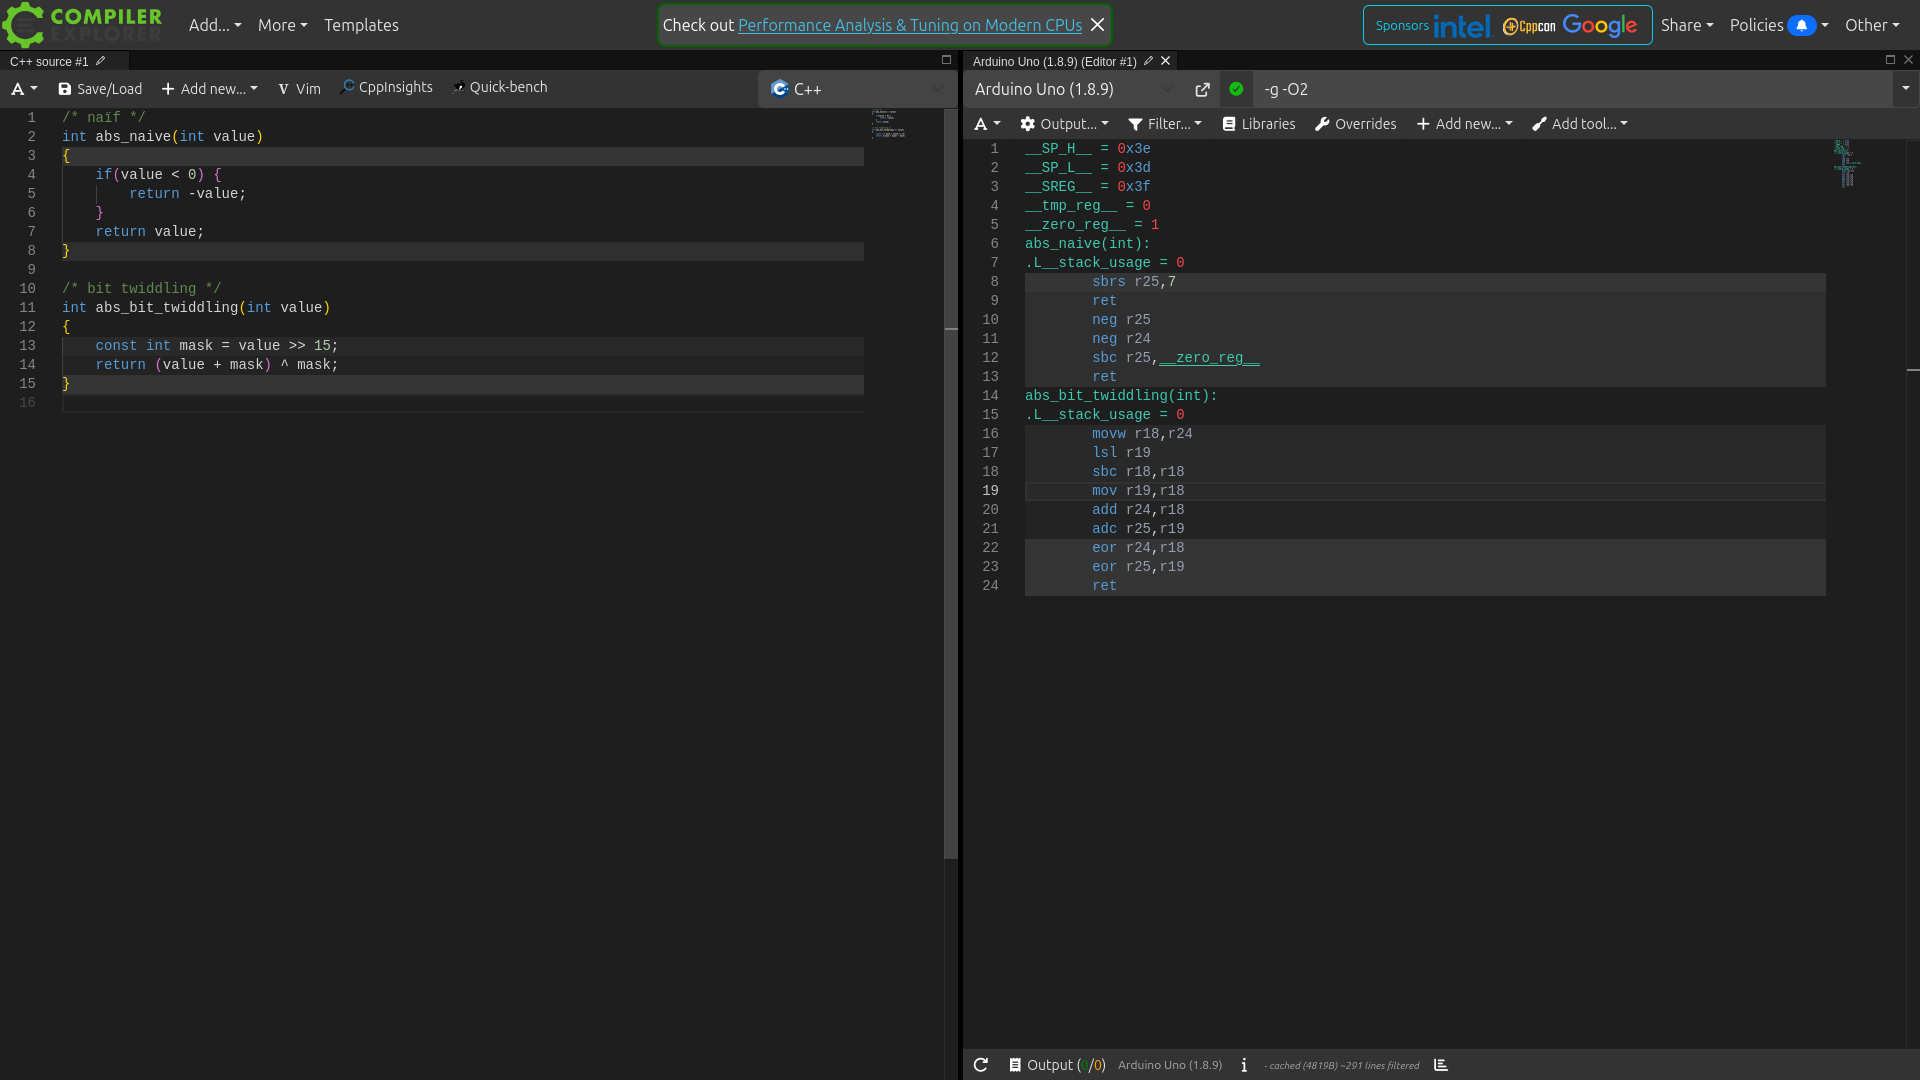
La version naïve est toujours meilleure !
(quel que soit le niveau d'optimisation)
ÉTENDRE LE SIGNE D'UN MOT
de 24-bits vers 32-bits
                                    /* naïf */
                                    int32_t sign_extend_24(int32_t value)
                                    {
                                        if(value & 0x800000) {
                                            value |= 0xff000000;
                                        }
                                        return value;
                                    }
                                    /* bit twiddling */
                                    int32_t sign_extend_24(int32_t value)
                                    {
                                        constexpr int32_t sign = (1UL << 23);
                                        return (value ^ sign) - sign;
                                    }
value ^ sign
Le OU exclusif bascule le bit de signe, le bit 23
- sign
La soustraction propage l'emprunt sur les 8 bits de poids fort
Deux opérations, sans test ni branchement
Généralisable à toute largeur en déplaçant le bit de signe
ÉTENDRE LE SIGNE D'UN MOT
GCC x86-64 sans optimisation
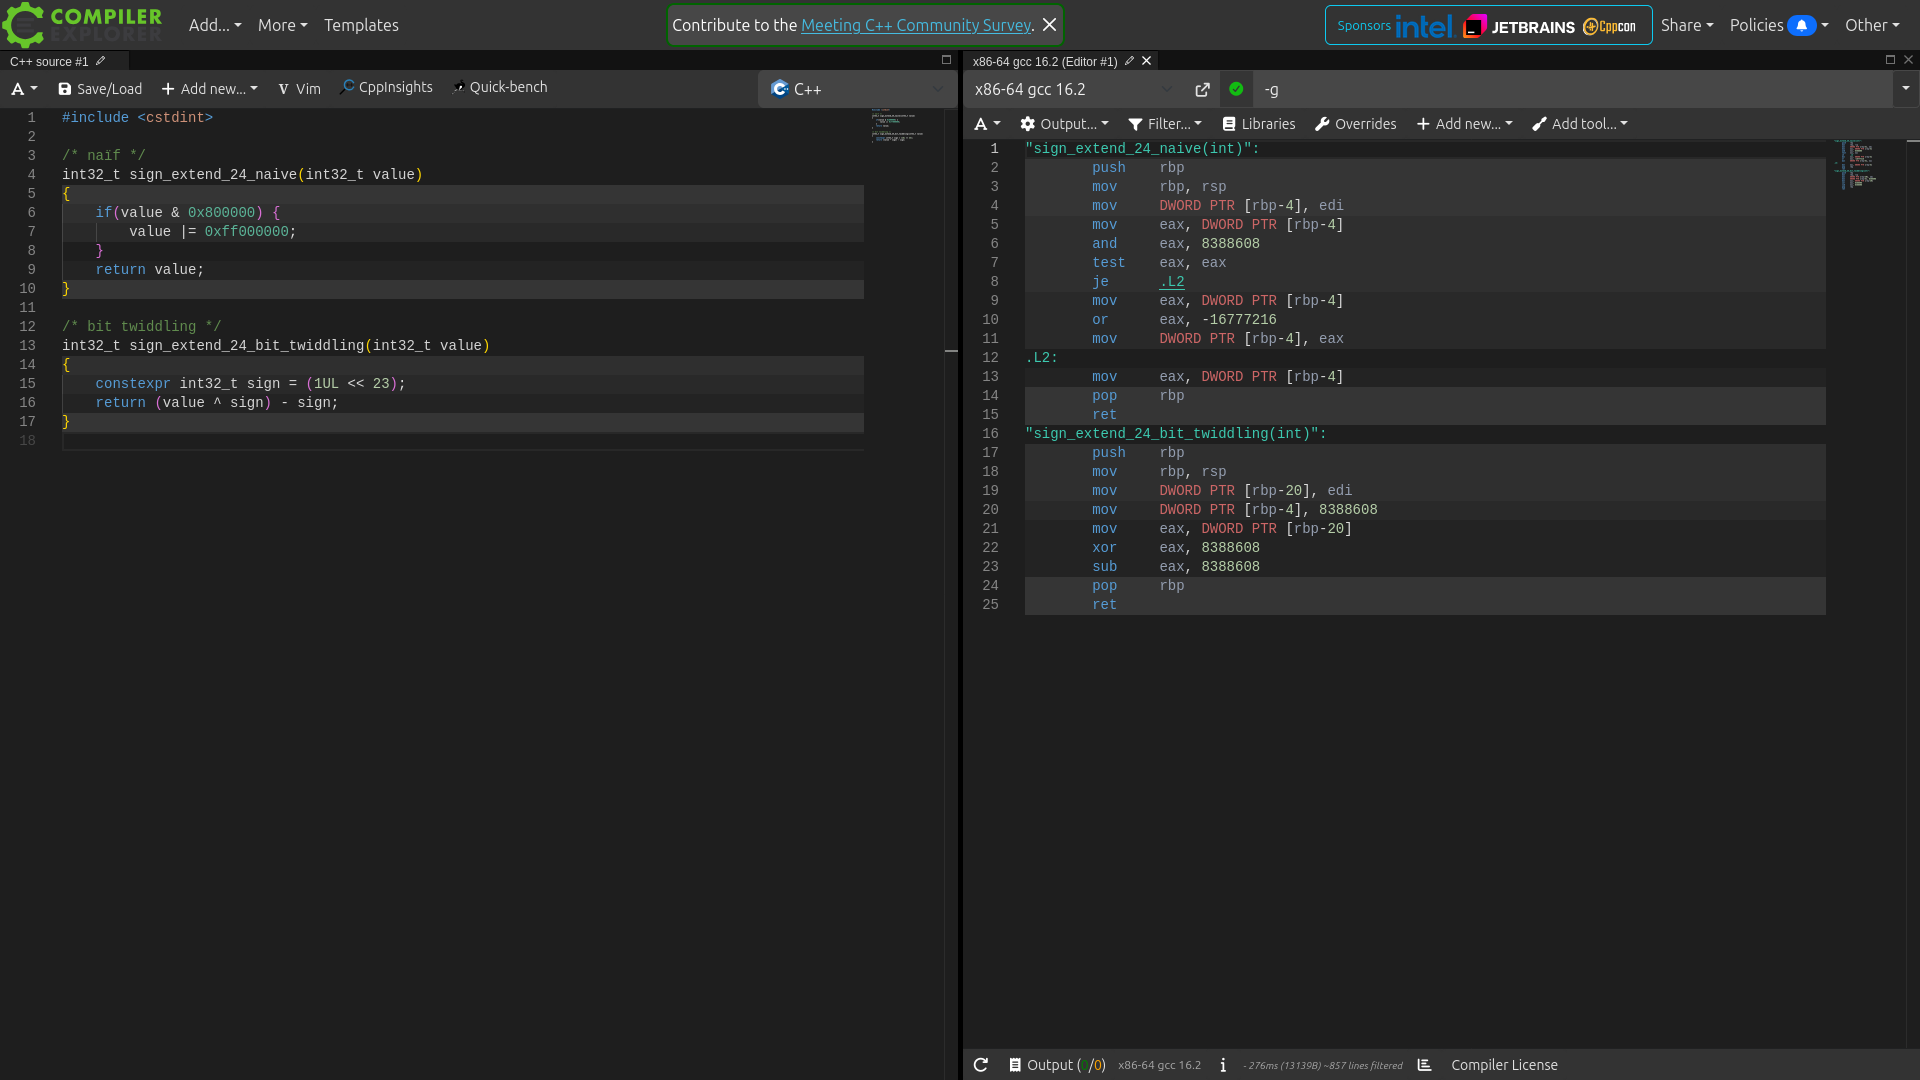
La version bit twiddling est meilleure
ÉTENDRE LE SIGNE D'UN MOT
Clang x86-64 sans optimisation
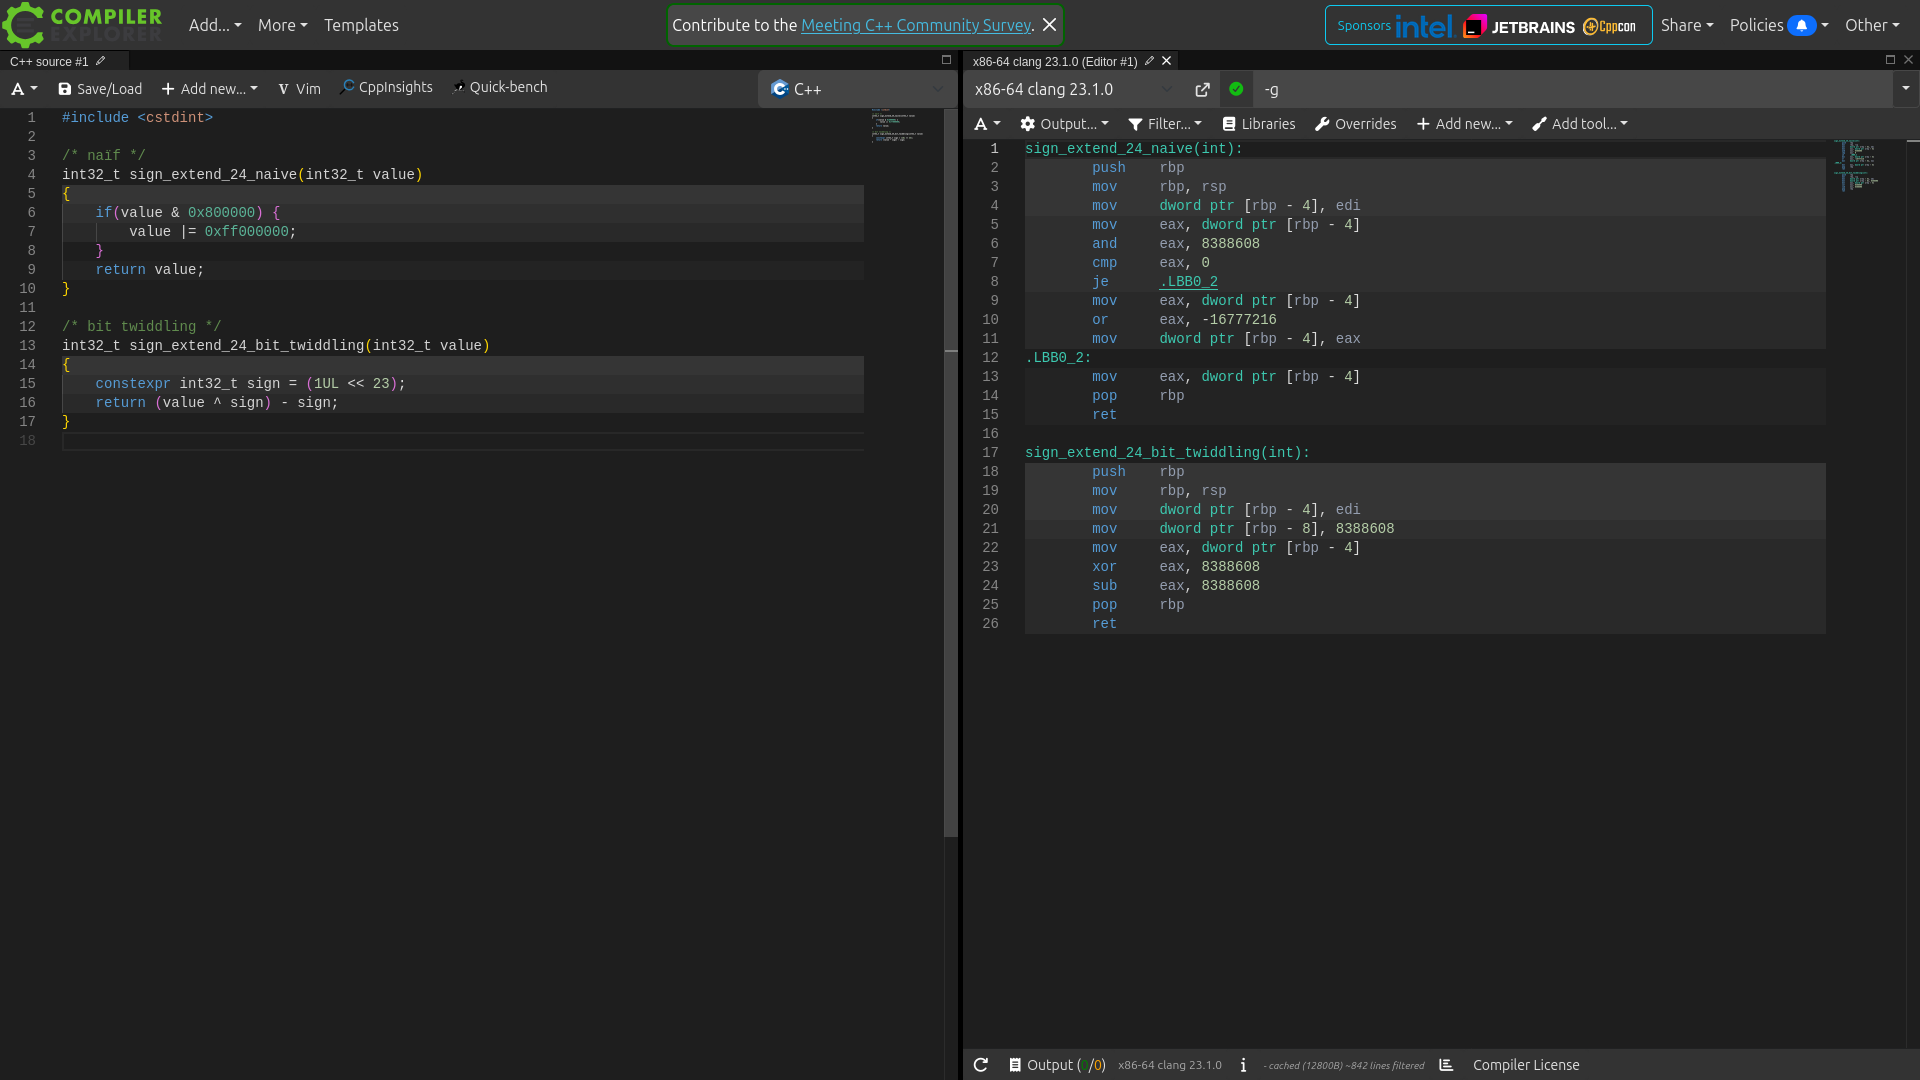
La version bit twiddling est meilleure
ÉTENDRE LE SIGNE D'UN MOT
GCC ARMv7 sans optimisation
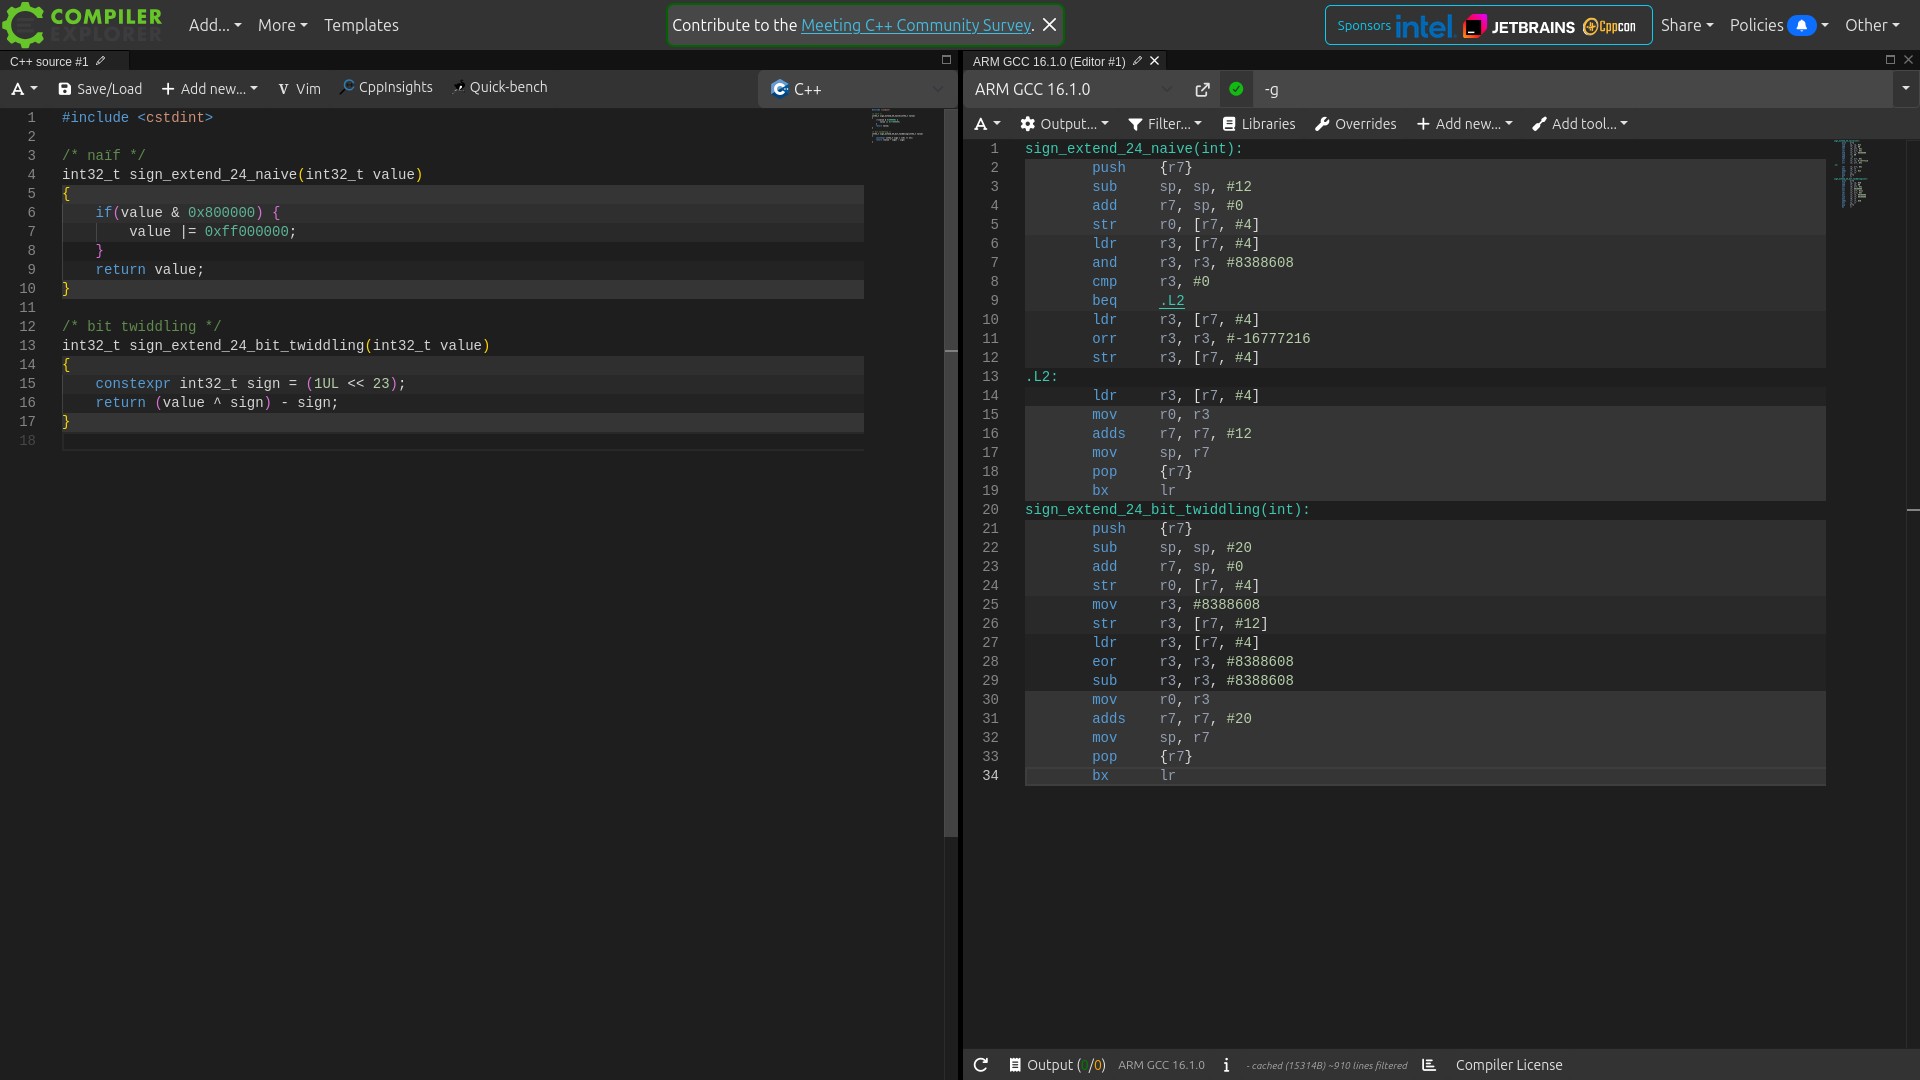
La version bit twiddling est meilleure
ÉTENDRE LE SIGNE D'UN MOT
Clang ARMv7 sans optimisation
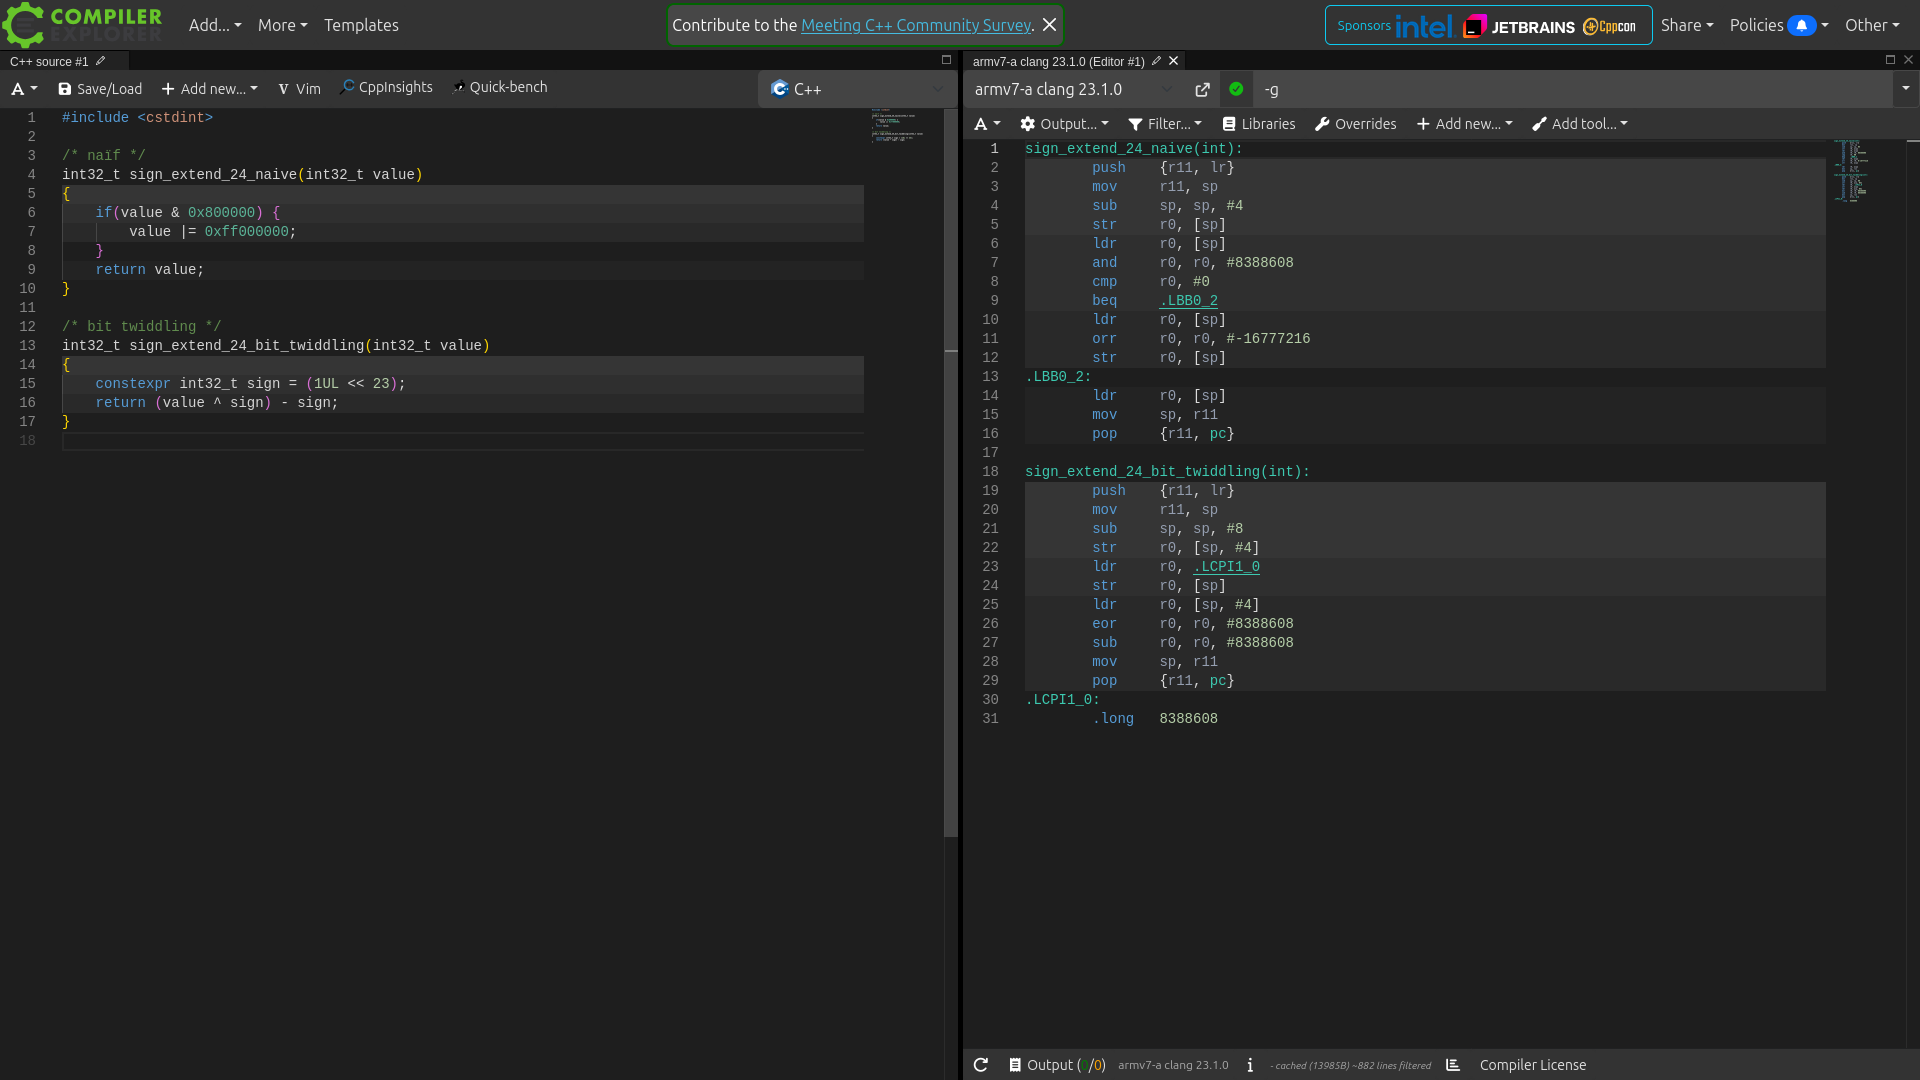
La version bit twiddling est meilleure
ÉTENDRE LE SIGNE D'UN MOT
GCC x86-64 avec optimisation
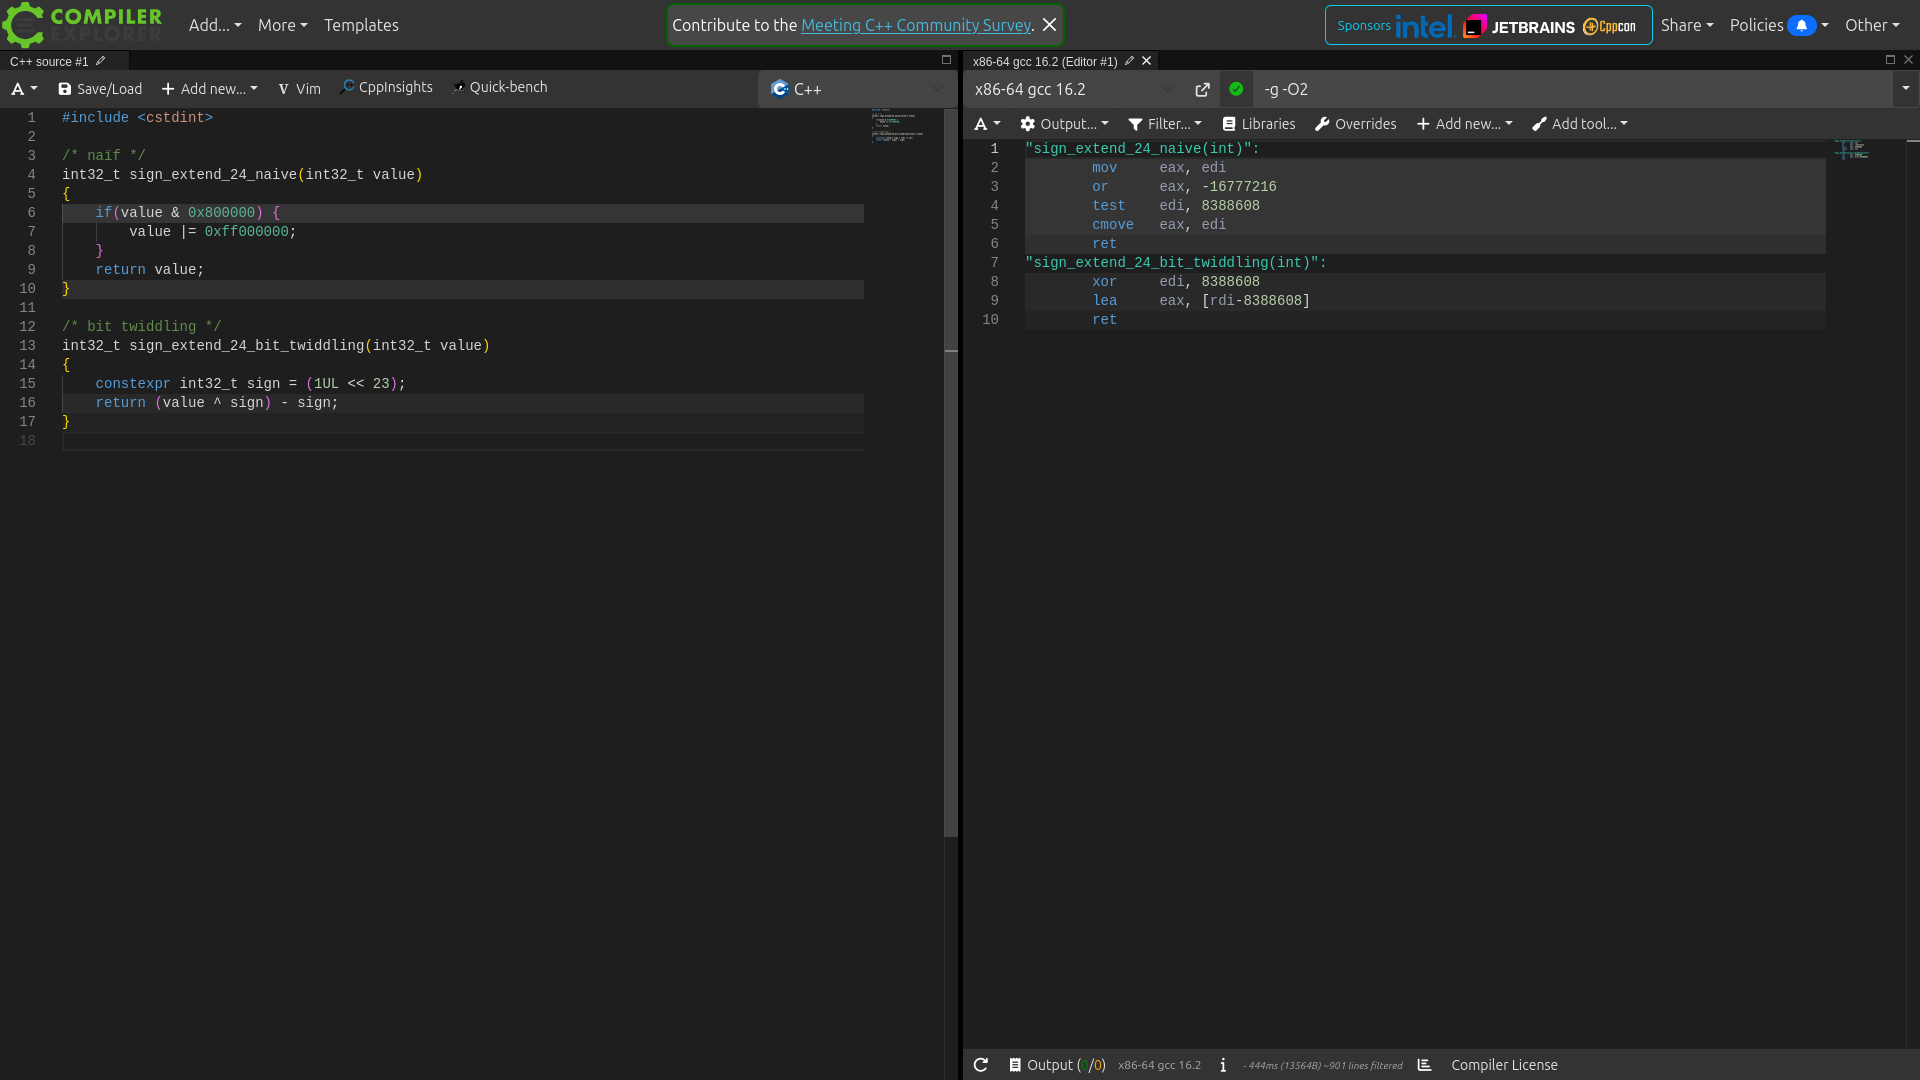
La version bit twiddling est meilleure
ÉTENDRE LE SIGNE D'UN MOT
Clang x86-64 avec optimisation
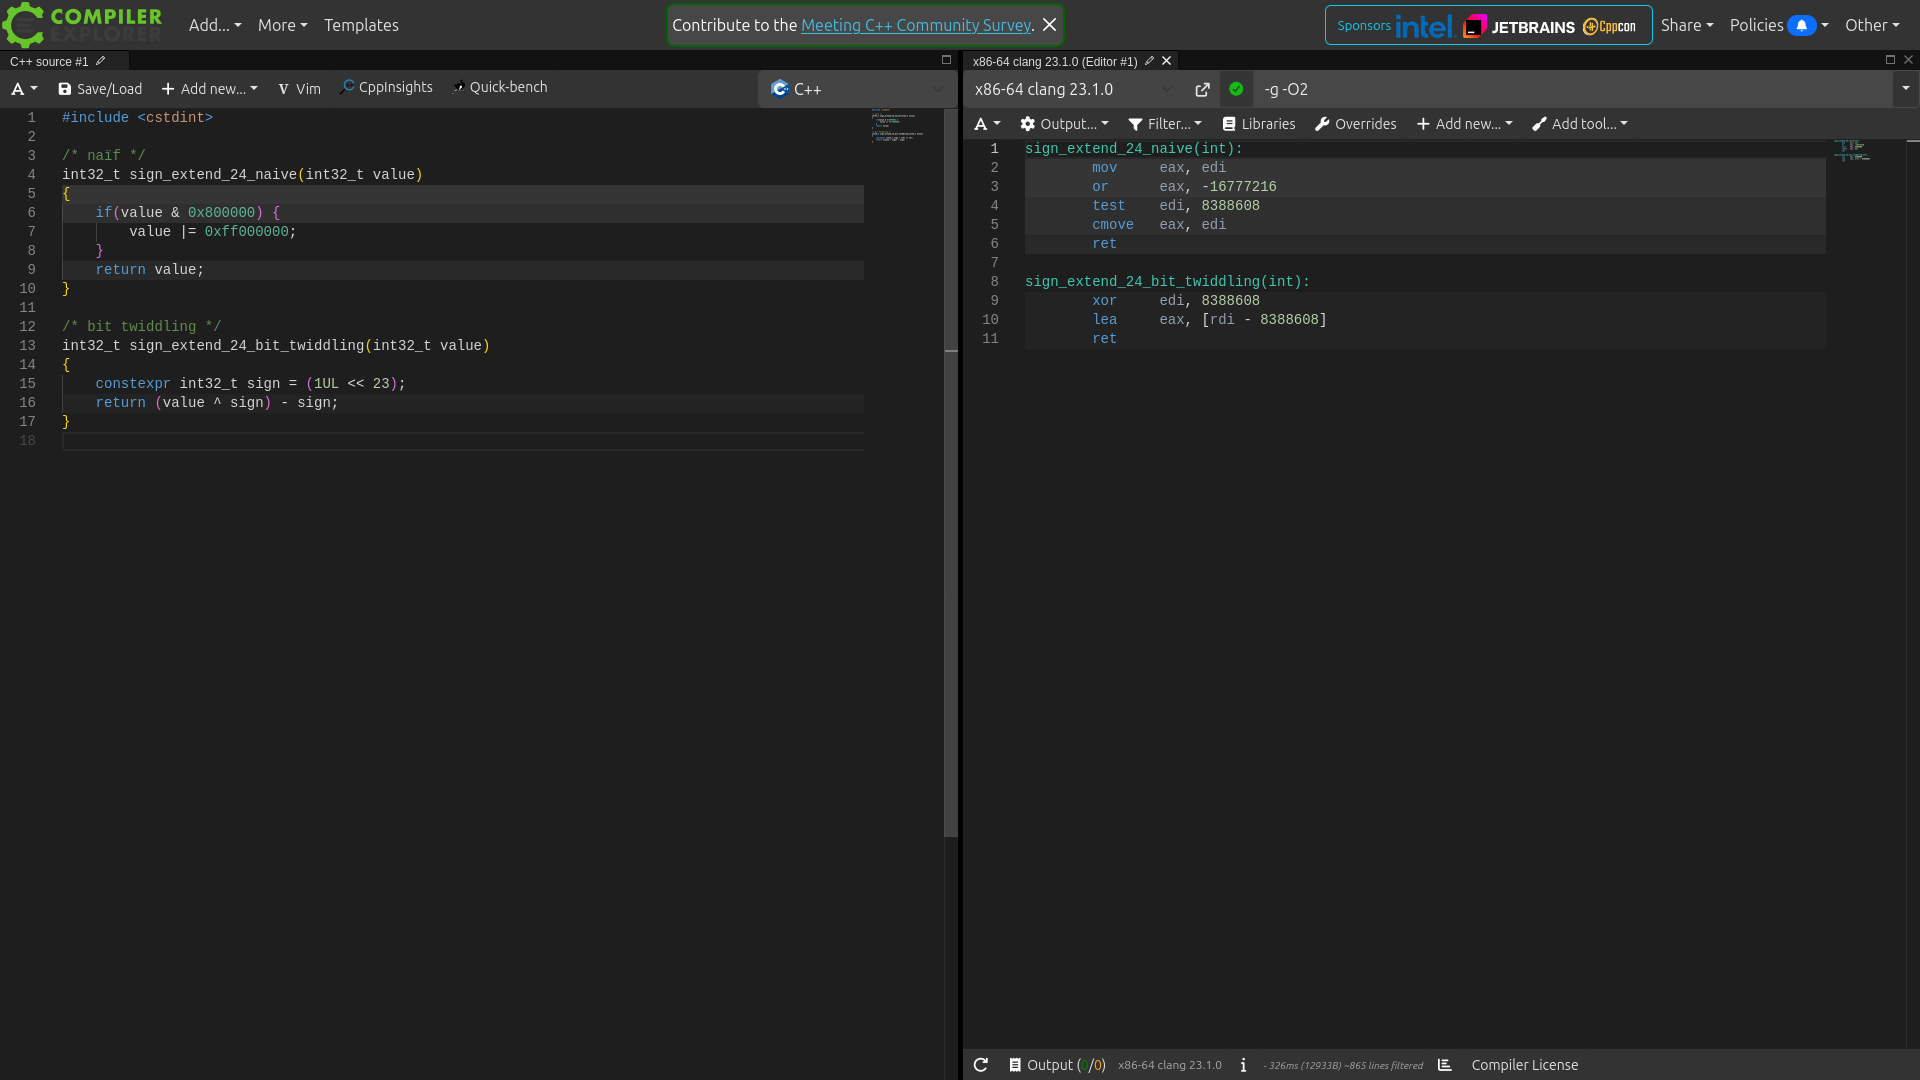
La version bit twiddling est meilleure
ÉTENDRE LE SIGNE D'UN MOT
GCC ARMv7 avec optimisation
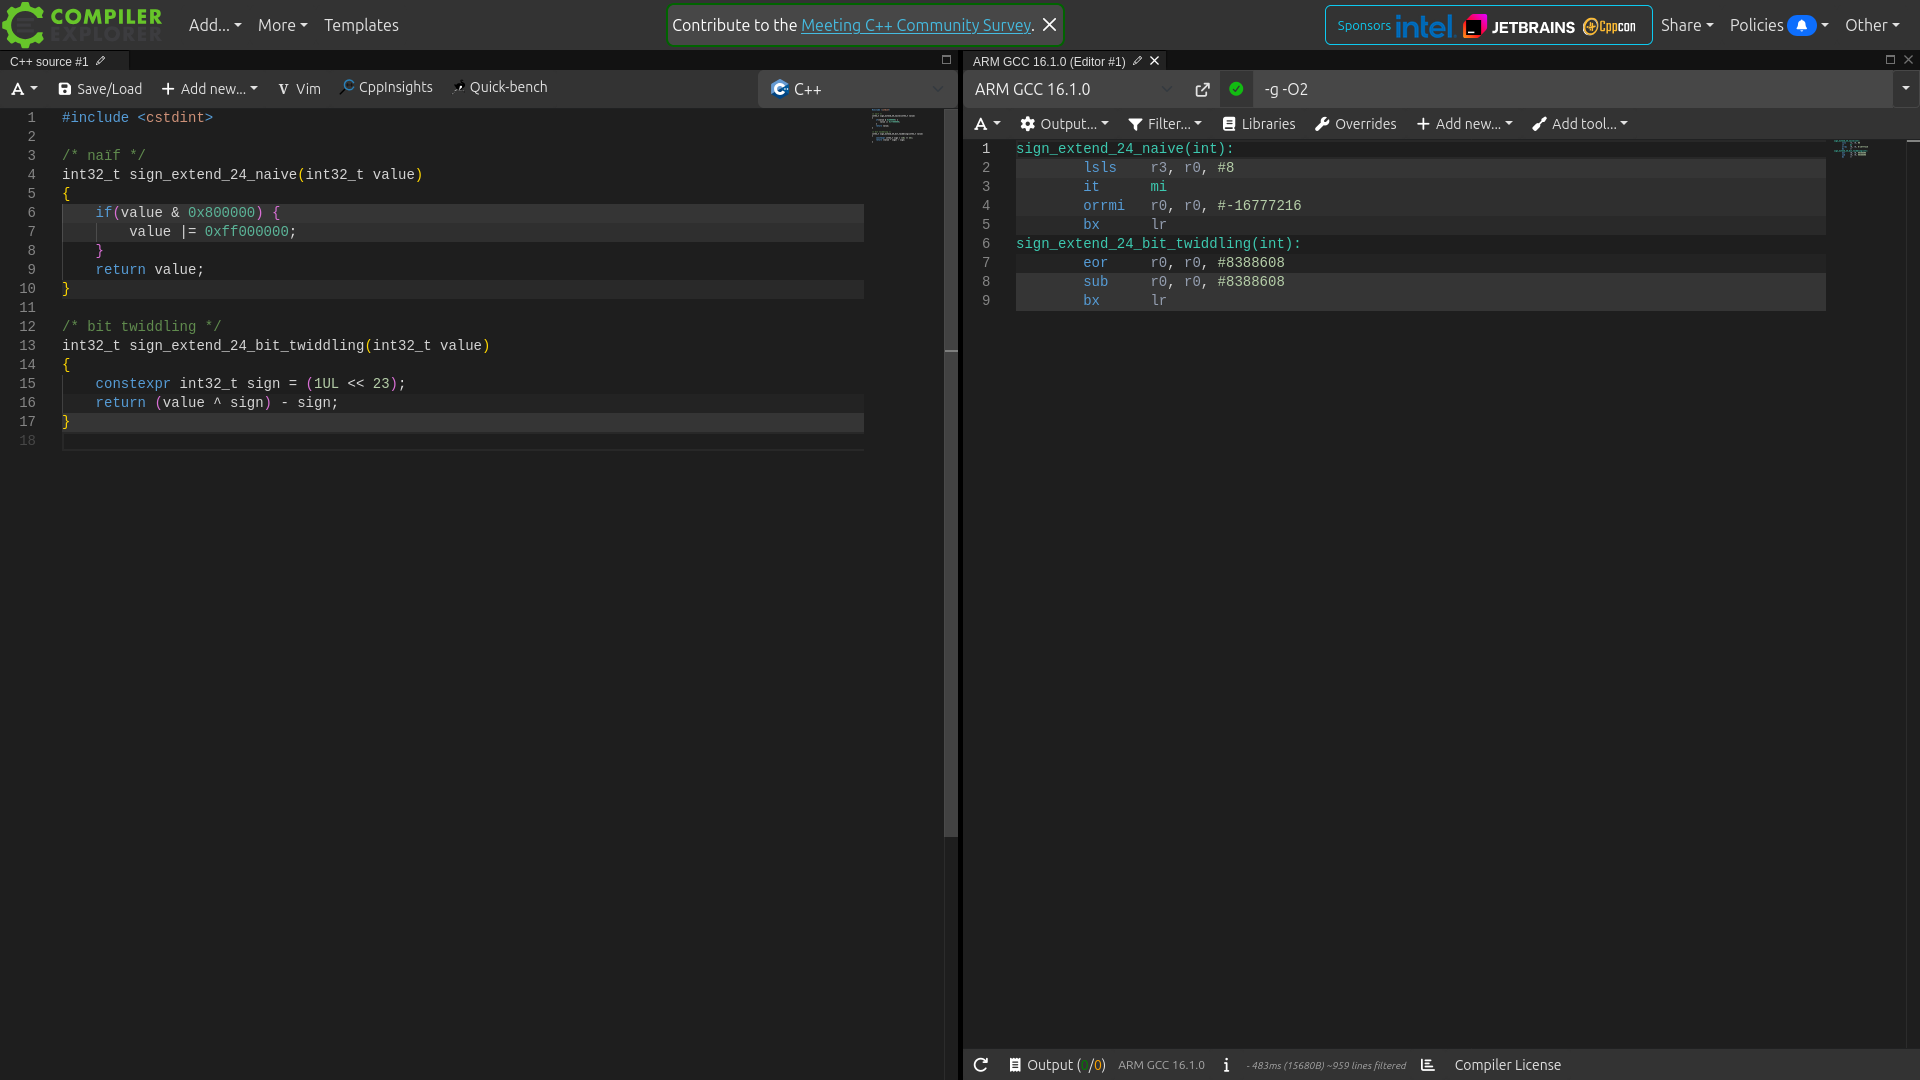
La version bit twiddling est meilleure
ÉTENDRE LE SIGNE D'UN MOT
Clang ARMv7 avec optimisation
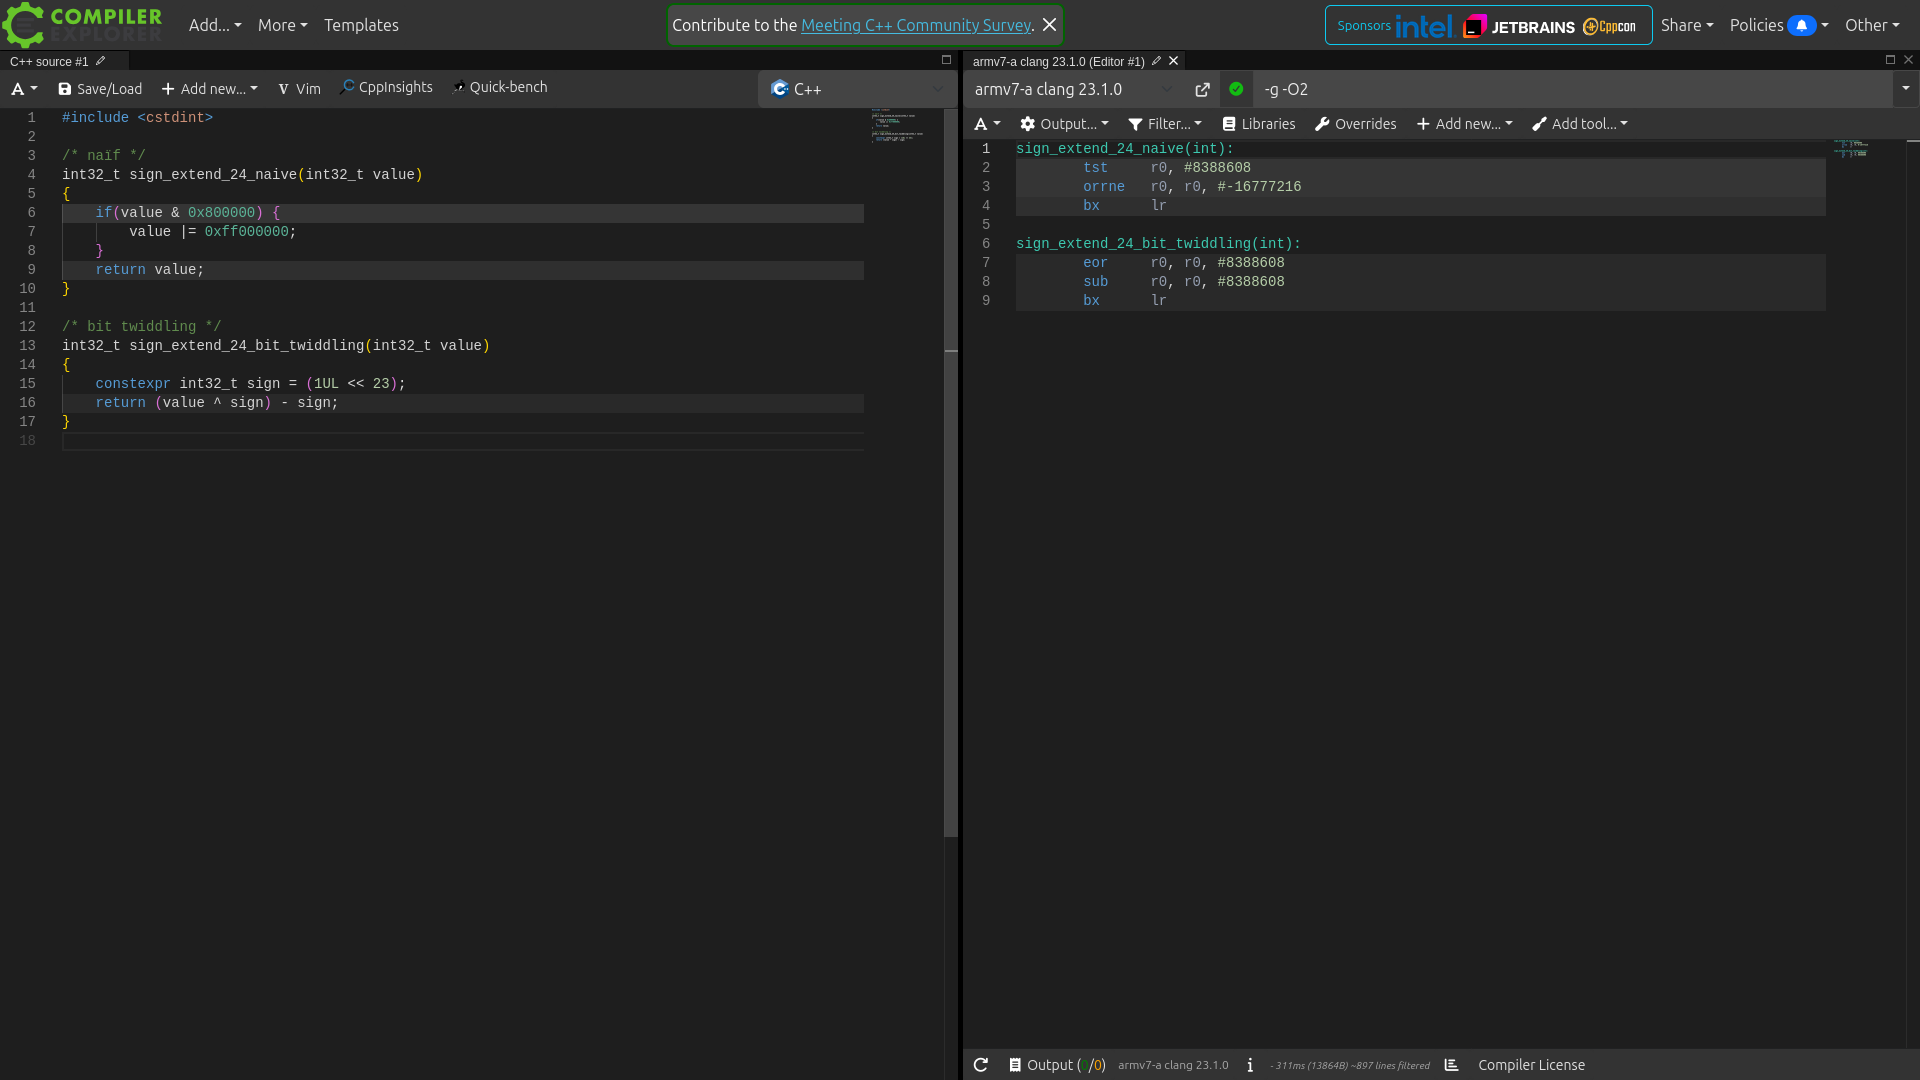
La version bit twiddling est meilleure
ÉTENDRE LE SIGNE D'UN MOT
Arduino Uno avec optimisation
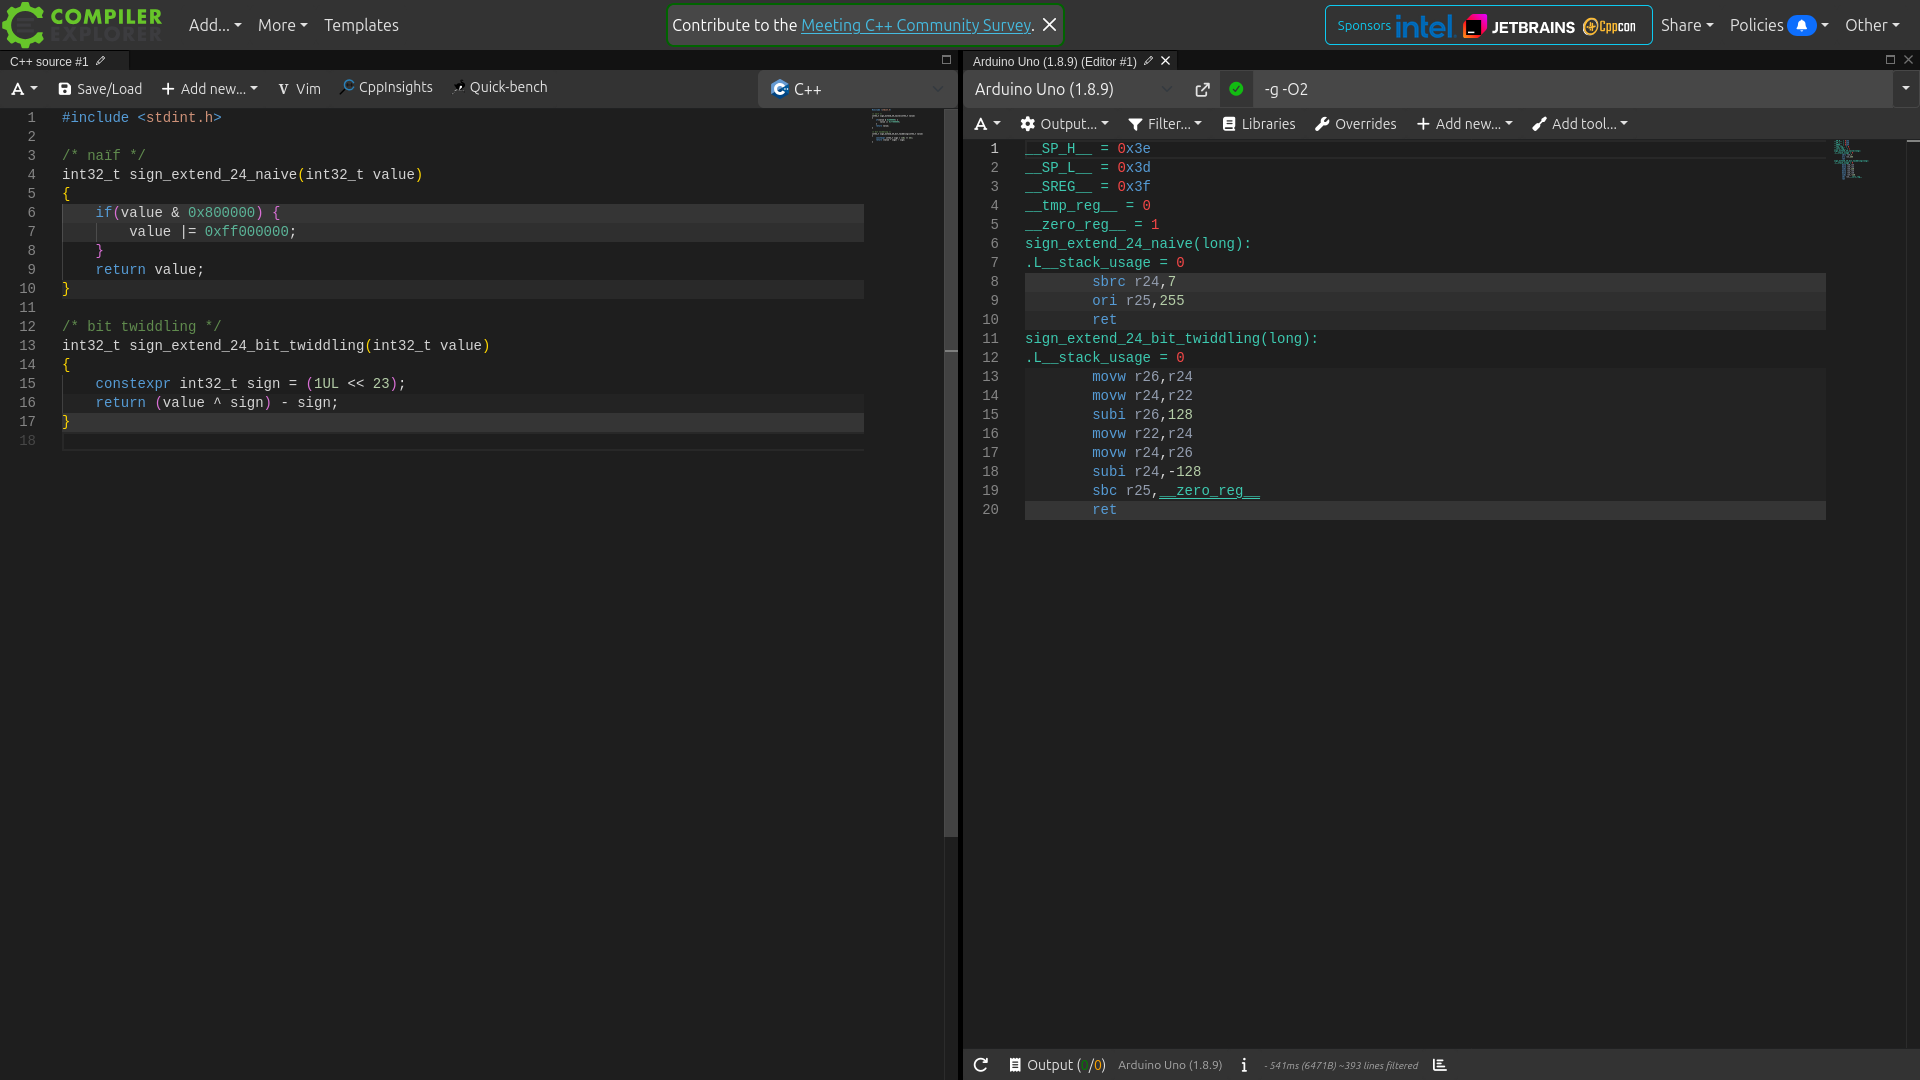
La version naïve est toujours meilleure !
(quel que soit le niveau d'optimisation)
CALCULER LA PARITÉ DE BITS
Avec un nombre magique
                                    /* naïf */
                                    int parity(unsigned int value)
                                    {
                                        int count = 0;
                                        while(value != 0) {
                                            count += (value & 1);
                                            value >>= 1;
                                        }
                                        return count & 1;
                                    }
                                    /* bit twiddling */
                                    int parity(unsigned int value)
                                    {
                                        value ^= value >> 16;
                                        value ^= value >> 8;
                                        value ^= value >> 4;
                                        value &= 0xf;
                                        return (0x6996 >> value) & 1;
                                    }
Repli par OU exclusif de la valeur d'entrée : 32 bits → 16 → 8 → 4
La parité est conservée à chaque étape du folding
0x6996 = 0b0110100110010110
La table de parité des 16 valeurs sur 4 bits, encodée dans une constante
CALCULER LA PARITÉ DE BITS
GCC x86-64 avec optimisation
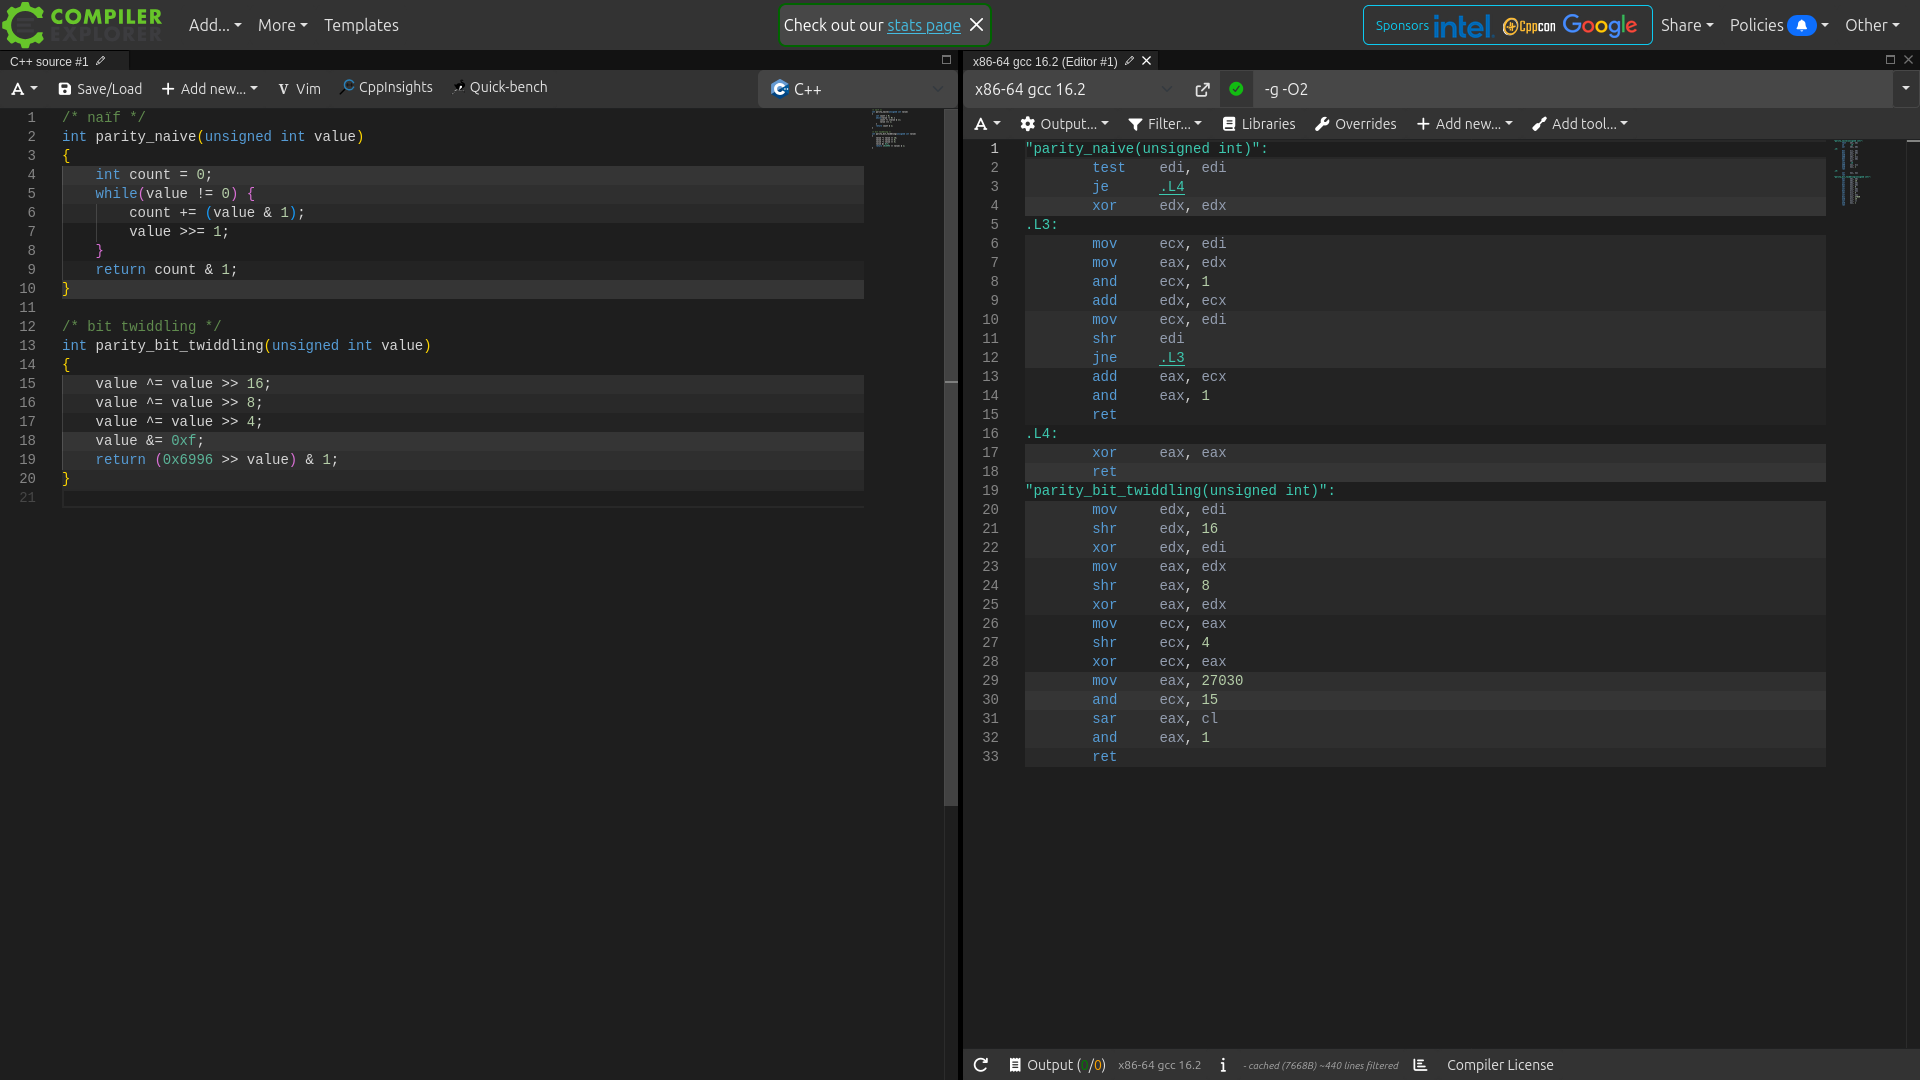
La version bit twiddling est toujours meilleure
(quel que soit le niveau d'optimisation)
CALCULER LA PARITÉ DE BITS
Clang x86-64 avec optimisation
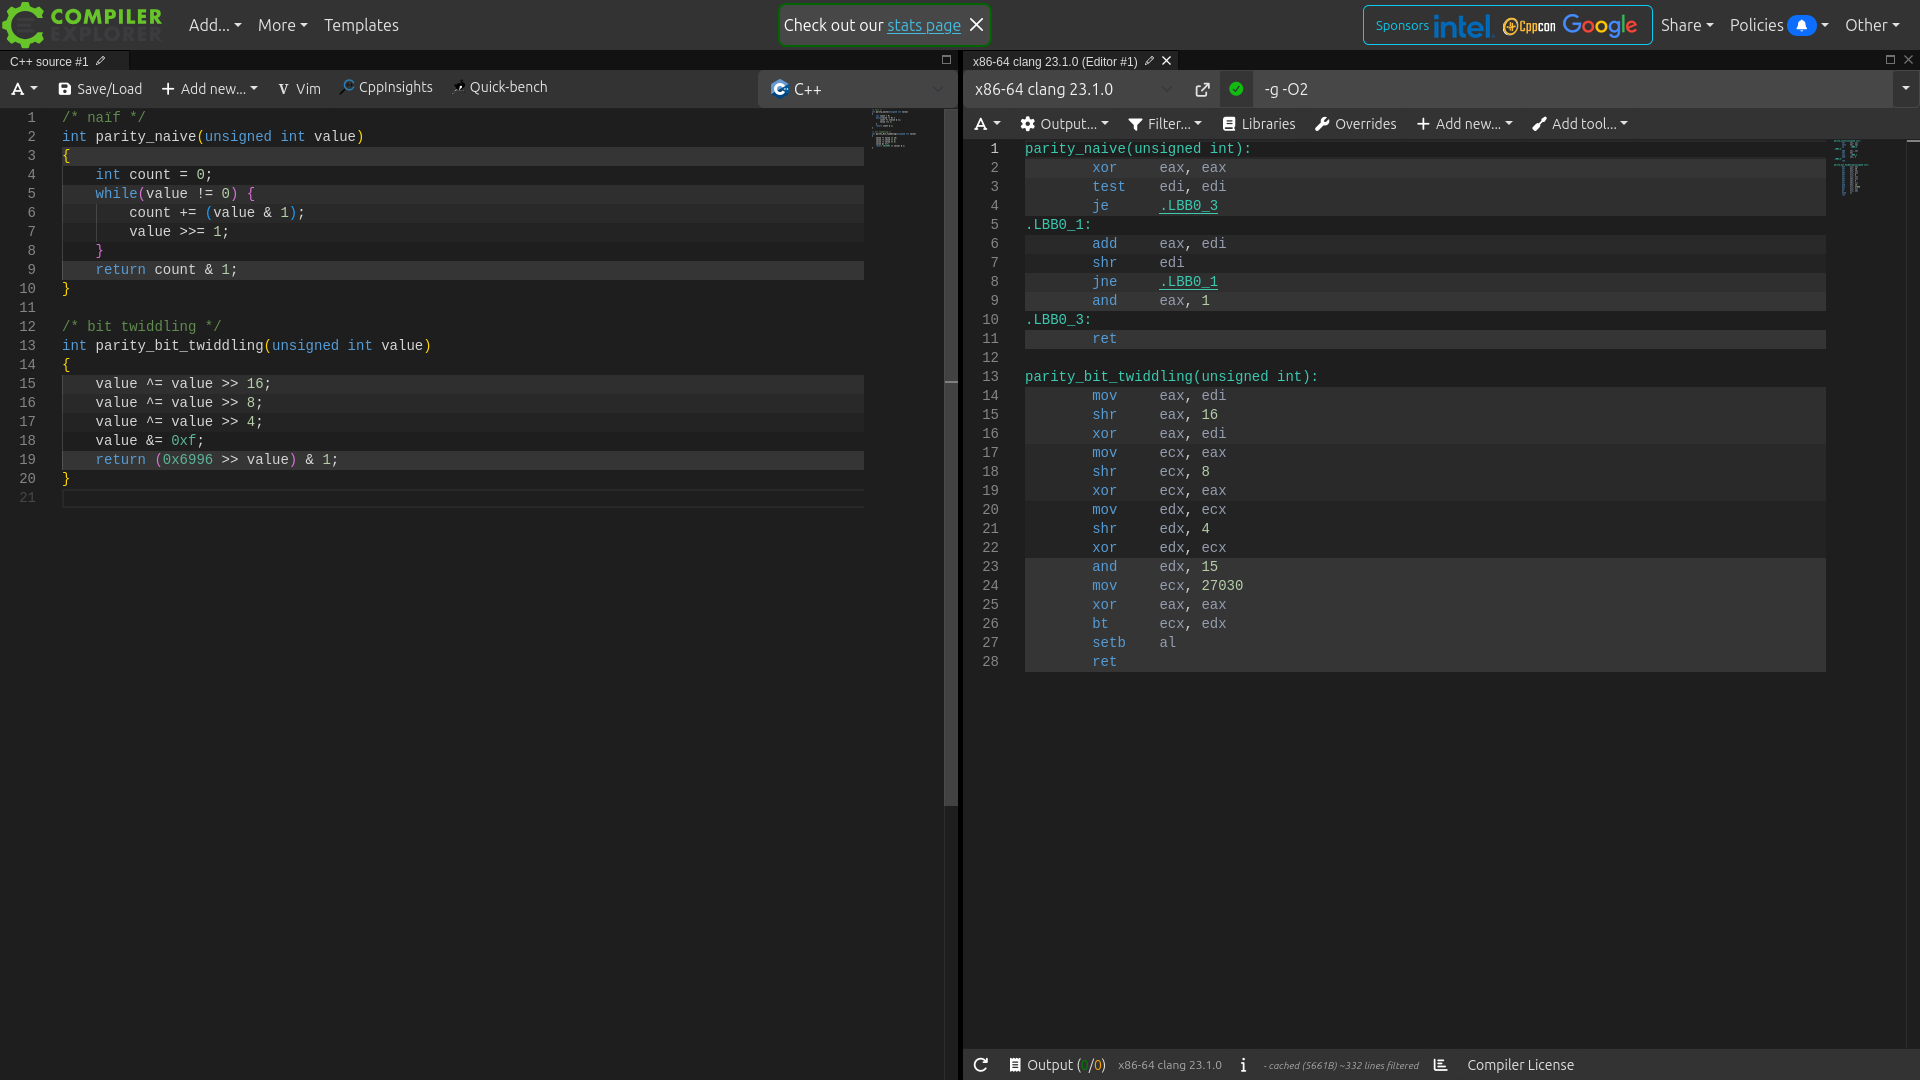
La version bit twiddling est toujours meilleure
(quel que soit le niveau d'optimisation)
CALCULER LA PARITÉ DE BITS
GCC ARMv7 avec optimisation
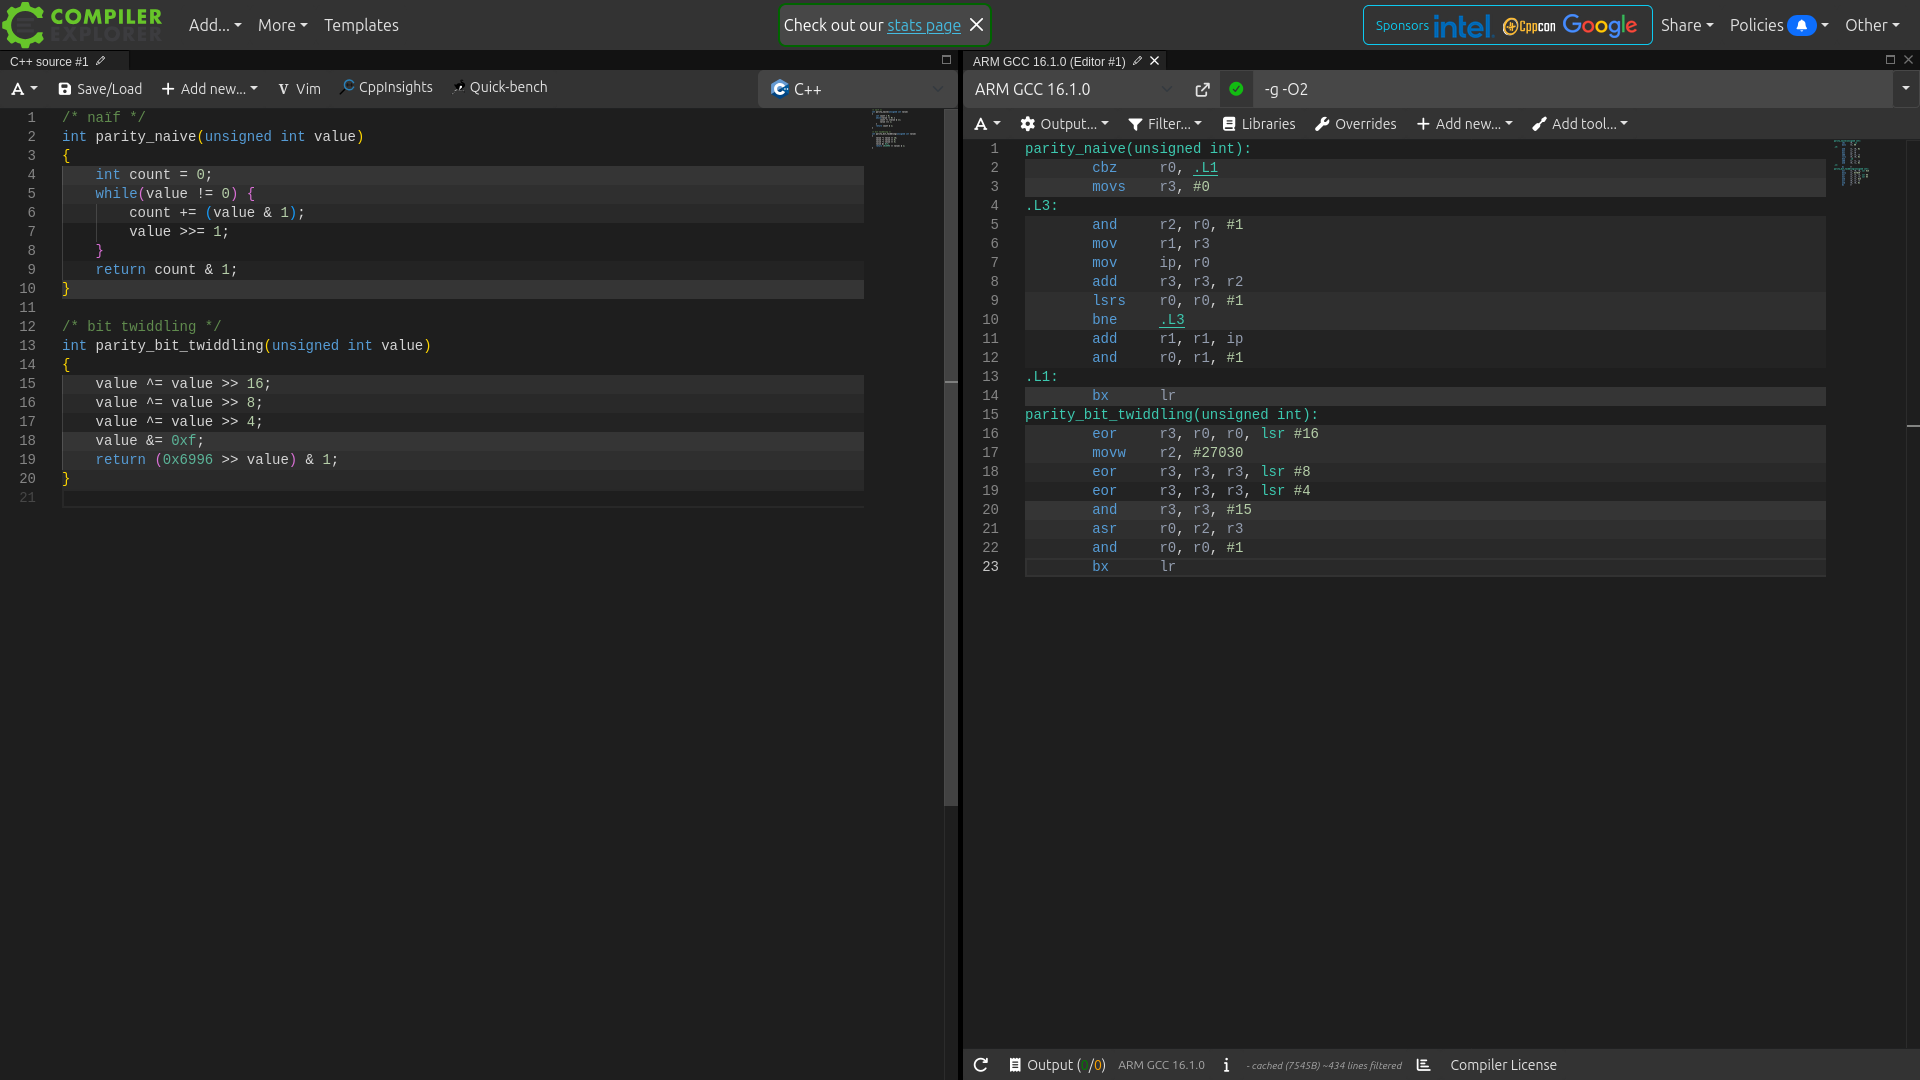
La version bit twiddling est toujours meilleure
(quel que soit le niveau d'optimisation)
CALCULER LA PARITÉ DE BITS
Clang ARMv7 avec optimisation
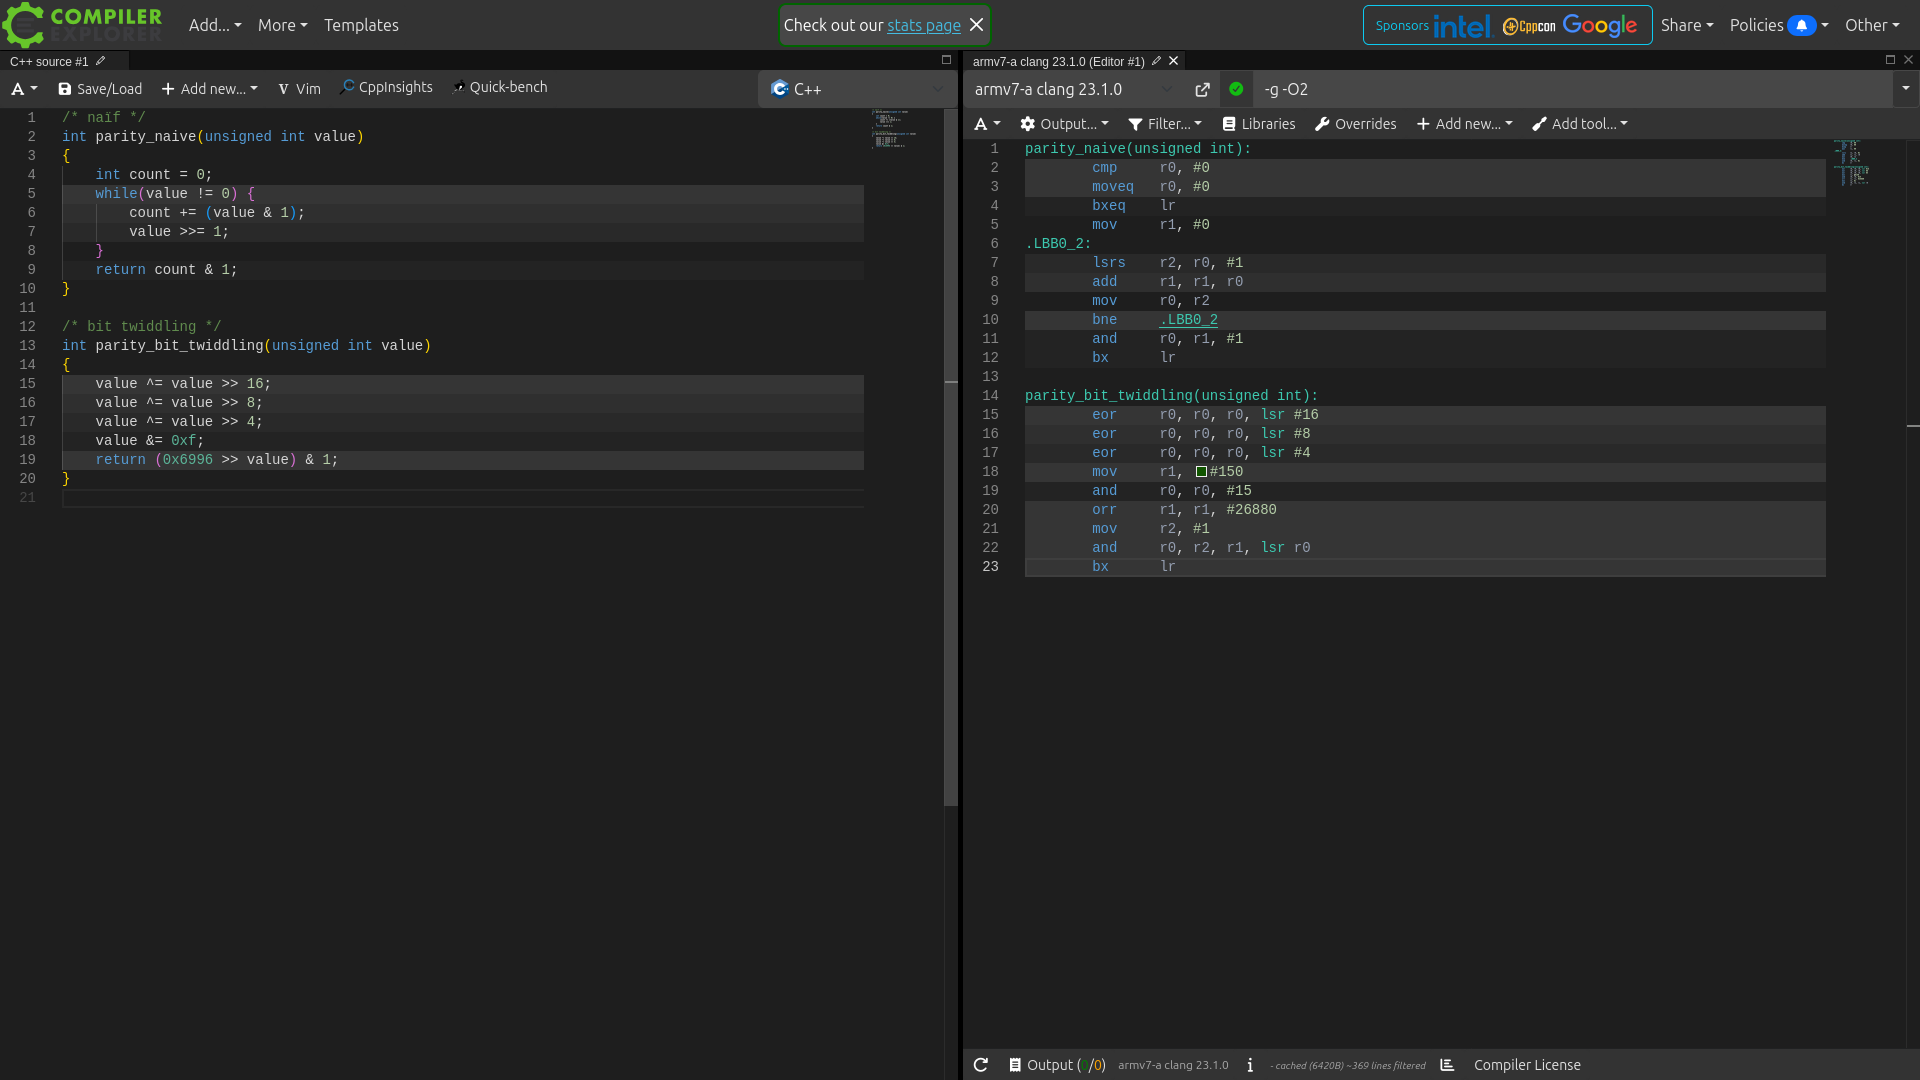
La version bit twiddling est toujours meilleure
(quel que soit le niveau d'optimisation)
DÉTECTER UN OCTET À ZÉRO
SWAR - SIMD WITHIN A REGISTER
                                    /* naïf */
                                    bool has_zero_byte(unsigned int value)
                                    {
                                        return !((value & 0x000000ff)
                                              && (value & 0x0000ff00)
                                              && (value & 0x00ff0000)
                                              && (value & 0xff000000));
                                    }
                                    /* bit twiddling */
                                    bool has_zero_byte(unsigned int value)
                                    {
                                        return (value - 0x01010101UL)
                                             & ~value & 0x80808080UL;
                                    }
value - 0x01010101
Soustrait 1 à chaque octet : un octet à zéro emprunte, passe à 0xff et allume son bit de poids fort
~value & 0x80808080
Isole le bit de poids fort des octets qui ne l'avaient pas déjà à 1 dans la valeur d'entrée, ce qui écarte ces faux positifs
Le ET des deux ne garde que les octets réellement à zéro
Un résultat non nul signale au moins un octet nul : quatre opérations, sans boucle ni branchement
DÉTECTER UN OCTET À ZÉRO
GCC x86-64 avec optimisation
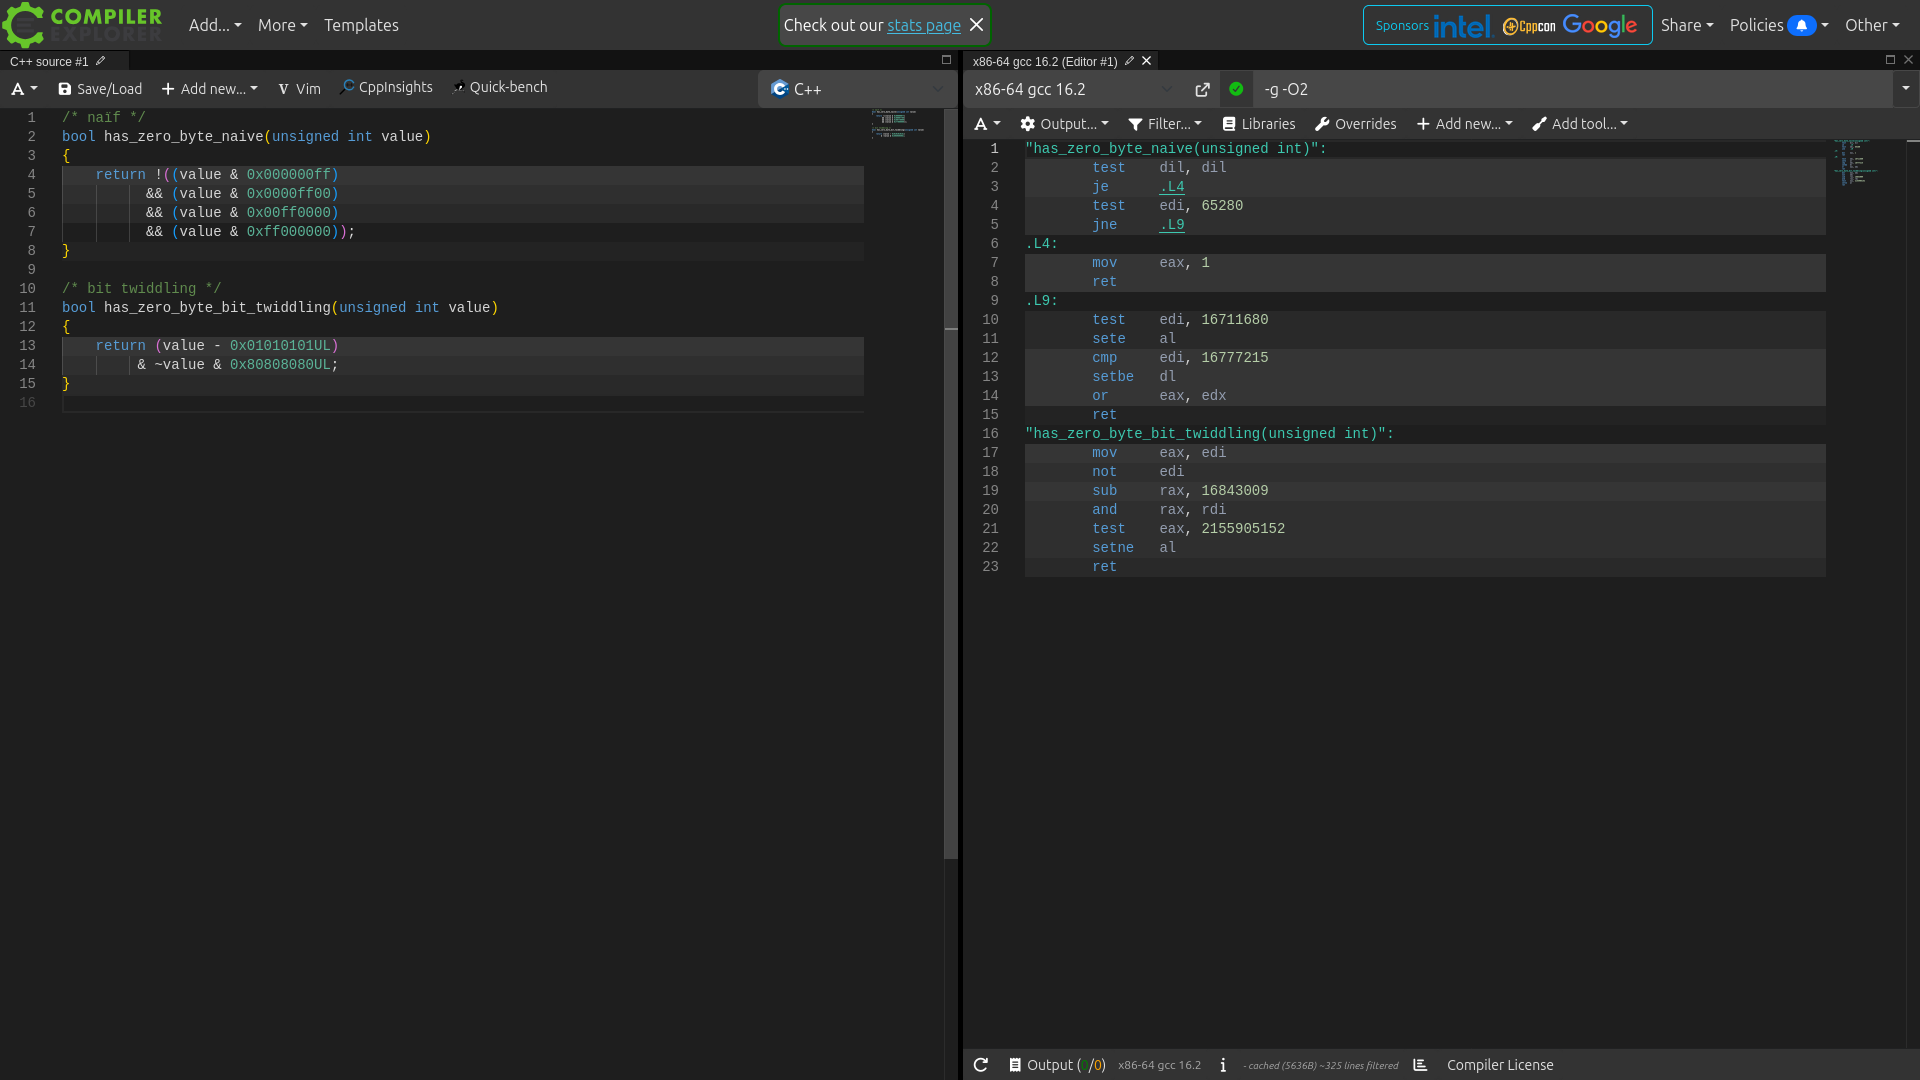
La version bit twiddling est toujours meilleure
(quel que soit le niveau d'optimisation)
DÉTECTER UN OCTET À ZÉRO
Clang x86-64 avec optimisation
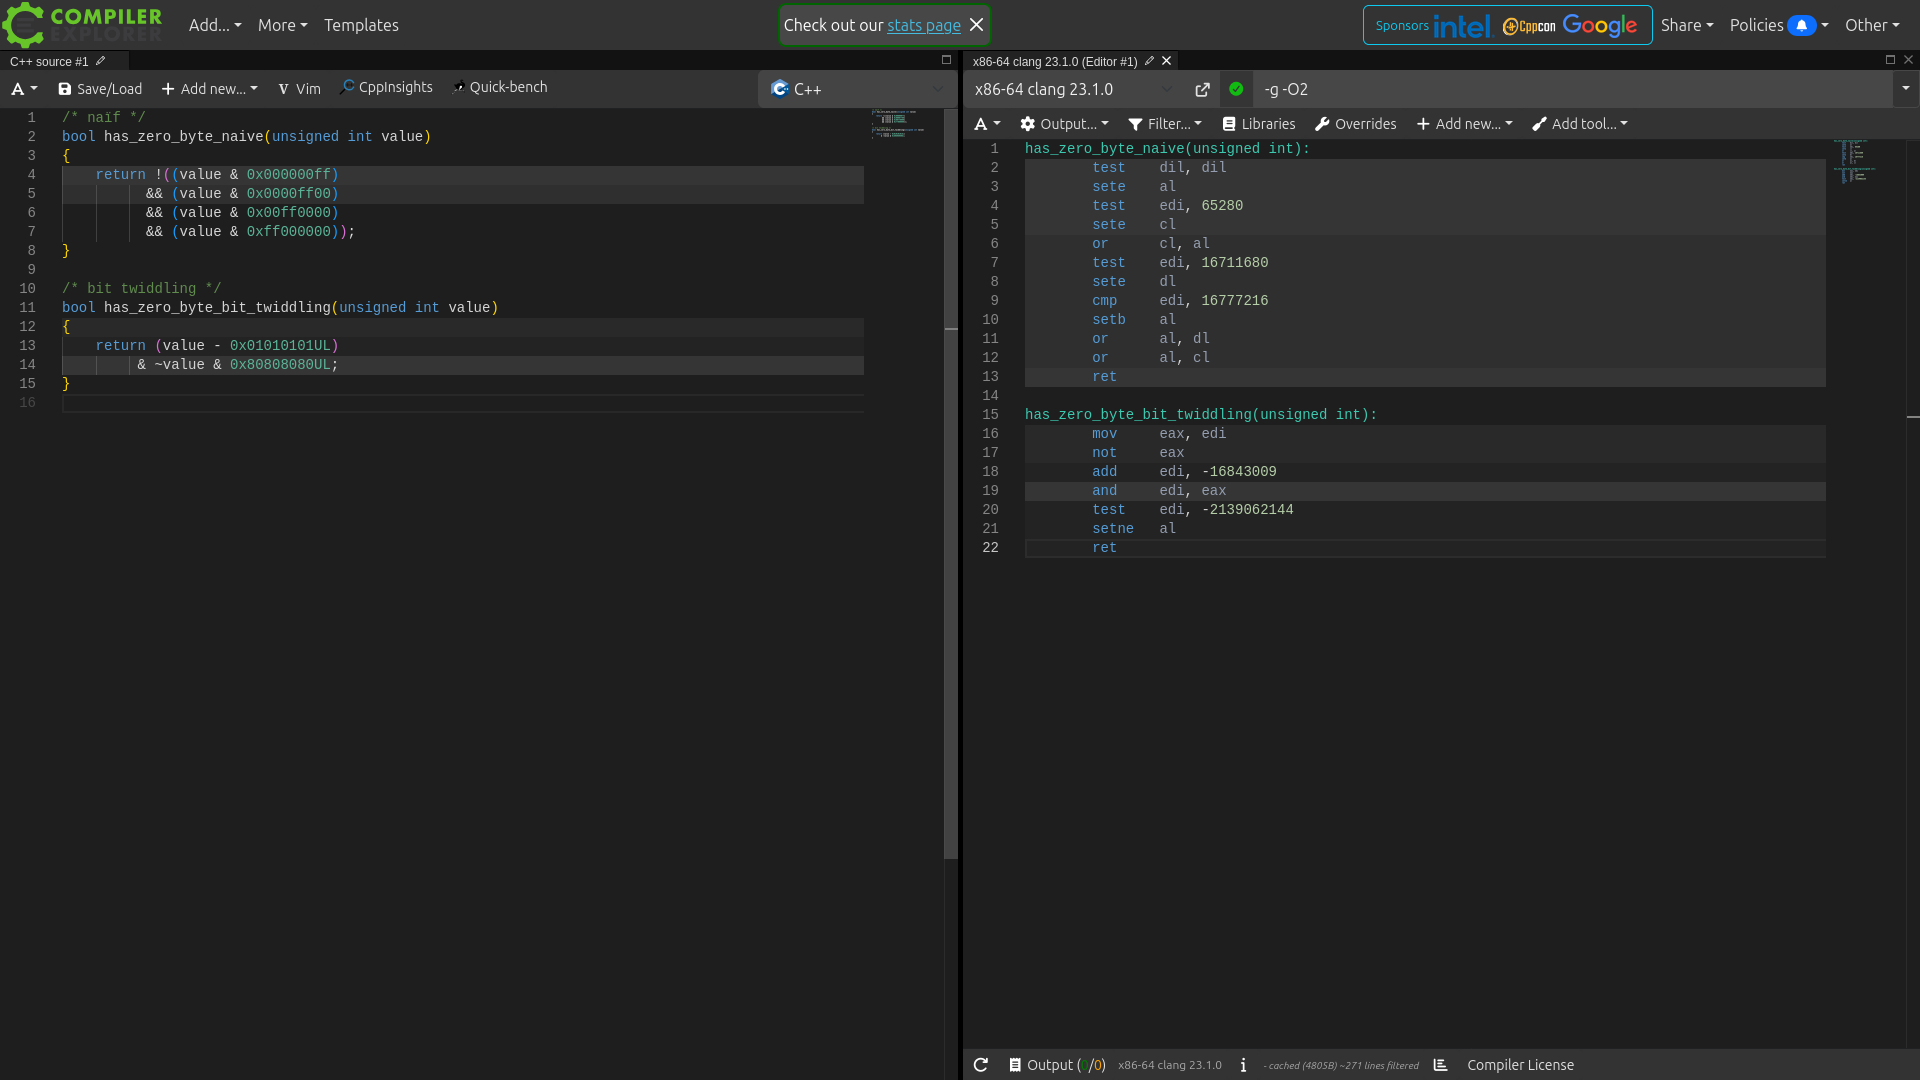
La version bit twiddling est toujours meilleure
(quel que soit le niveau d'optimisation)
DÉTECTER UN OCTET À ZÉRO
GCC ARMv7 avec optimisation
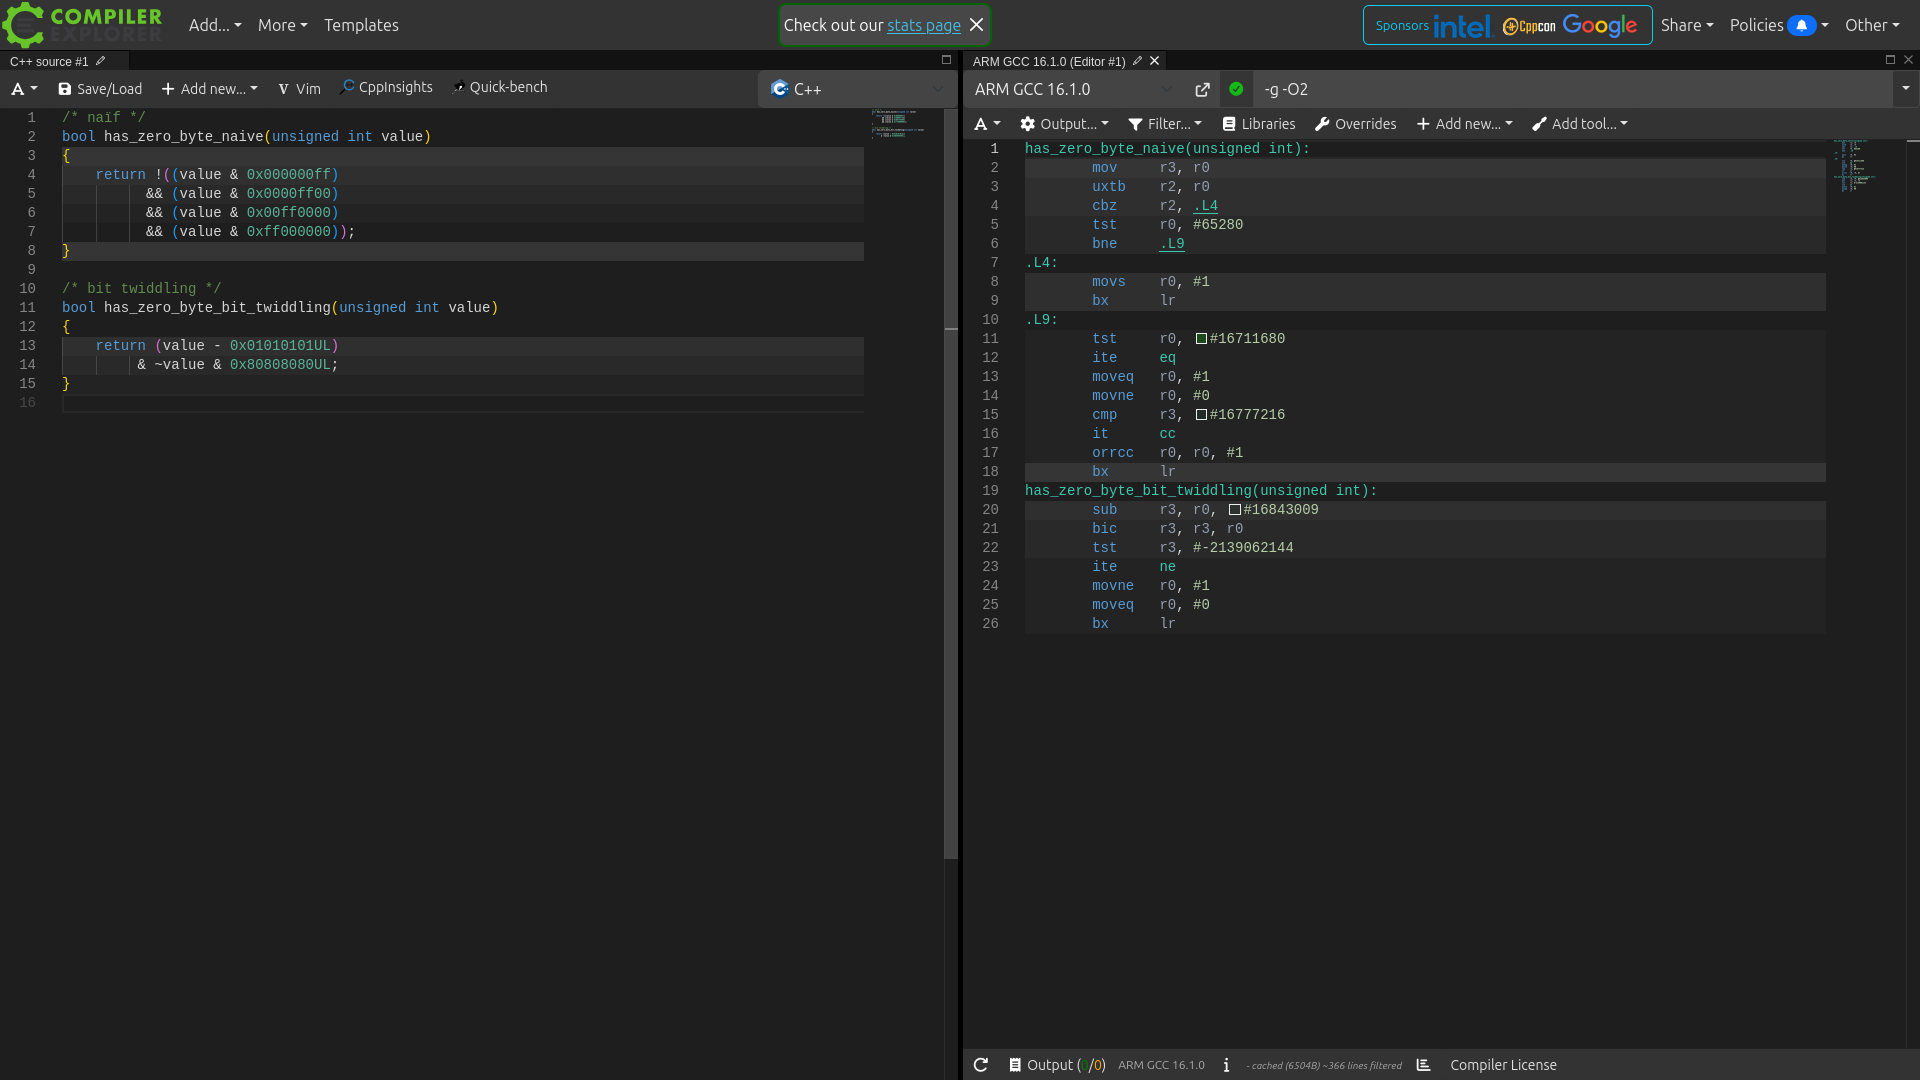
La version bit twiddling est toujours meilleure
(quel que soit le niveau d'optimisation)
DÉTECTER UN OCTET À ZÉRO
Clang ARMv7 avec optimisation
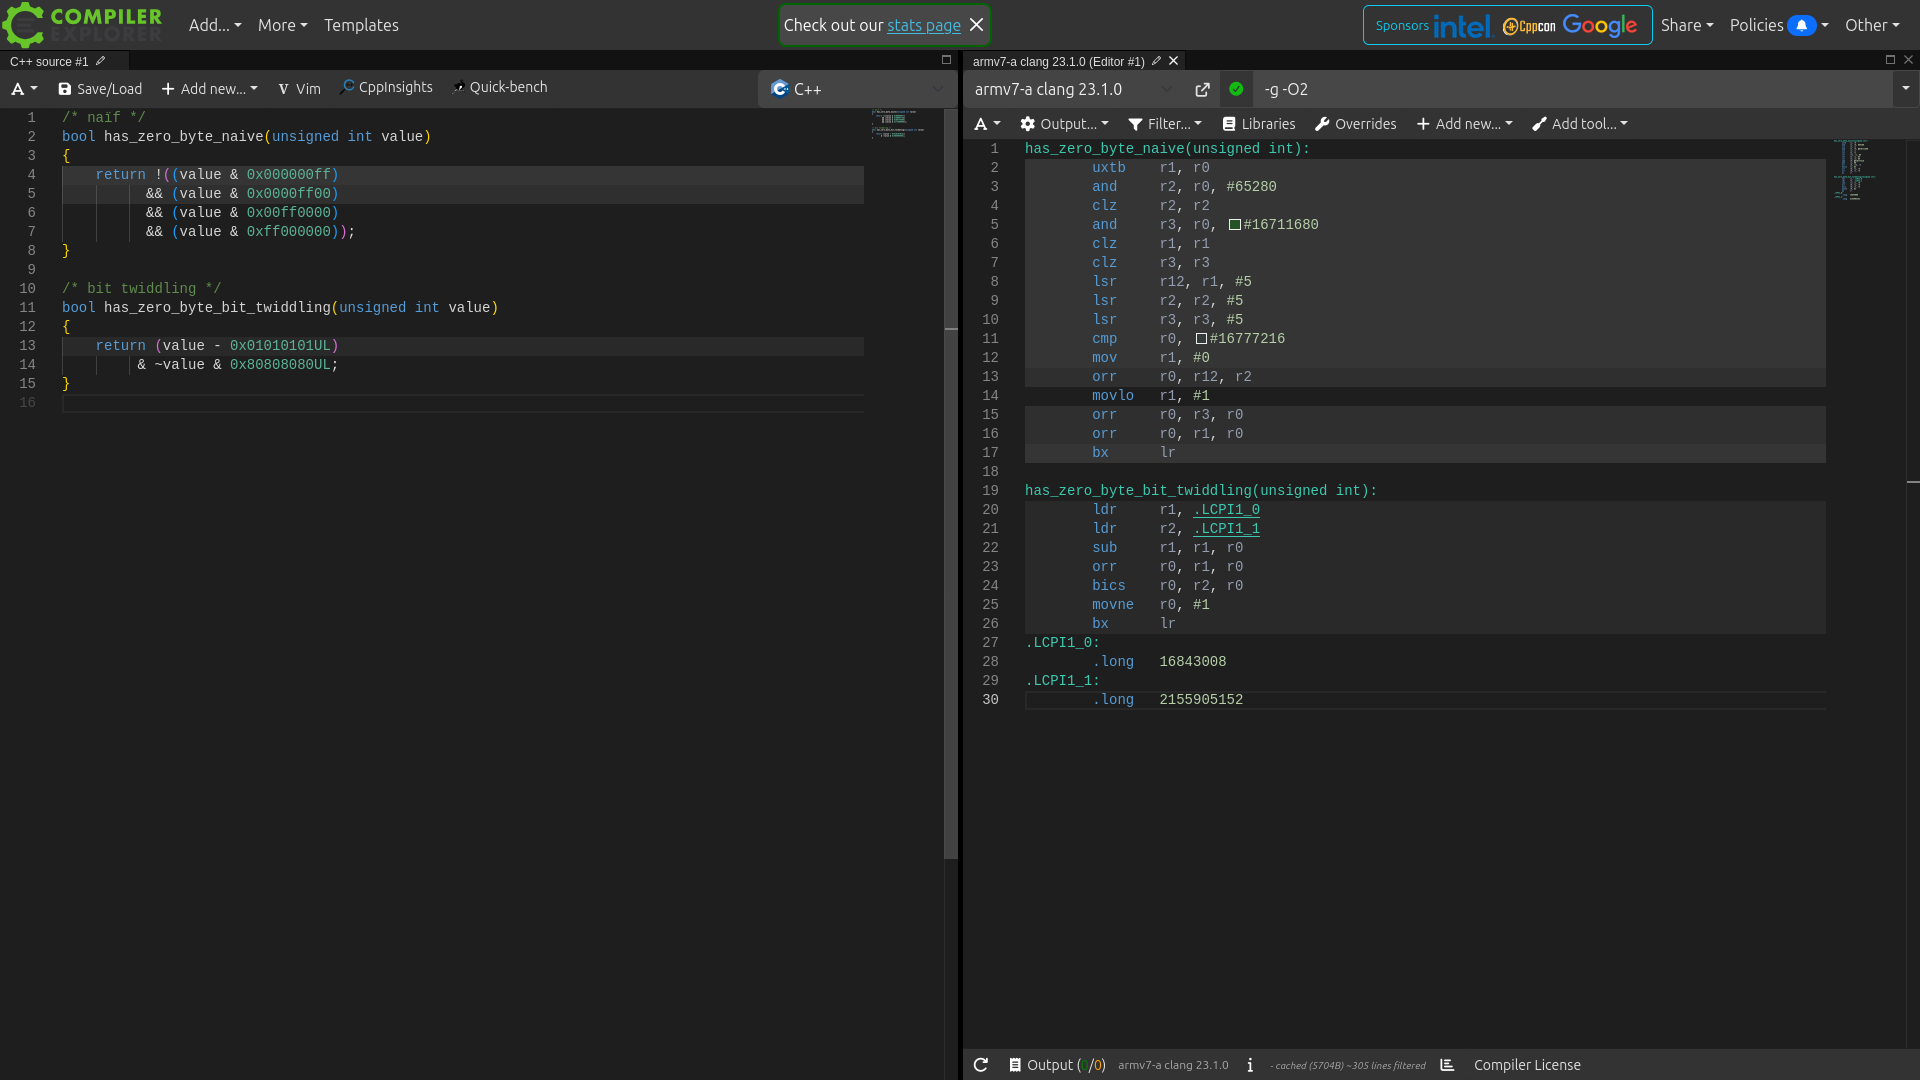
La version bit twiddling est toujours meilleure
(quel que soit le niveau d'optimisation)
INVERSER L'ORDRE DES BITS D'UN OCTET
Deux multiplications et un masque
                                    /* naïf */
                                    unsigned char reverse_byte(unsigned char value)
                                    {
                                        unsigned char result = 0;
                                        for(int count = 0; count < 8; ++count) {
                                            result = (result << 1) | (value & 1);
                                            value >>= 1;
                                        }
                                        return result;
                                    }
                                    /* bit twiddling */
                                    unsigned char reverse_byte(unsigned char value)
                                    {
                                        return ((value * 0x80200802ULL)
                                              & 0x0884422110ULL)
                                              * 0x0101010101ULL >> 32;
                                    }
value * 0x80200802 & 0x0884422110
Éparpille quatre copies de l'octet dans un mot de 64 bits, aux décalages de 1, 11, 21 et 31 bits
Ne conserve qu'un seul exemplaire de chaque bit, déjà placé dans l'ordre inverse
* 0x0101010101 >> 32
La multiplication recolle les bits isolés en un seul octet, le décalage le ramène à sa place
Au total 4 opérations, sans boucle ni test
INVERSER L'ORDRE DES BITS D'UN OCTET
GCC x86-64 avec optimisation
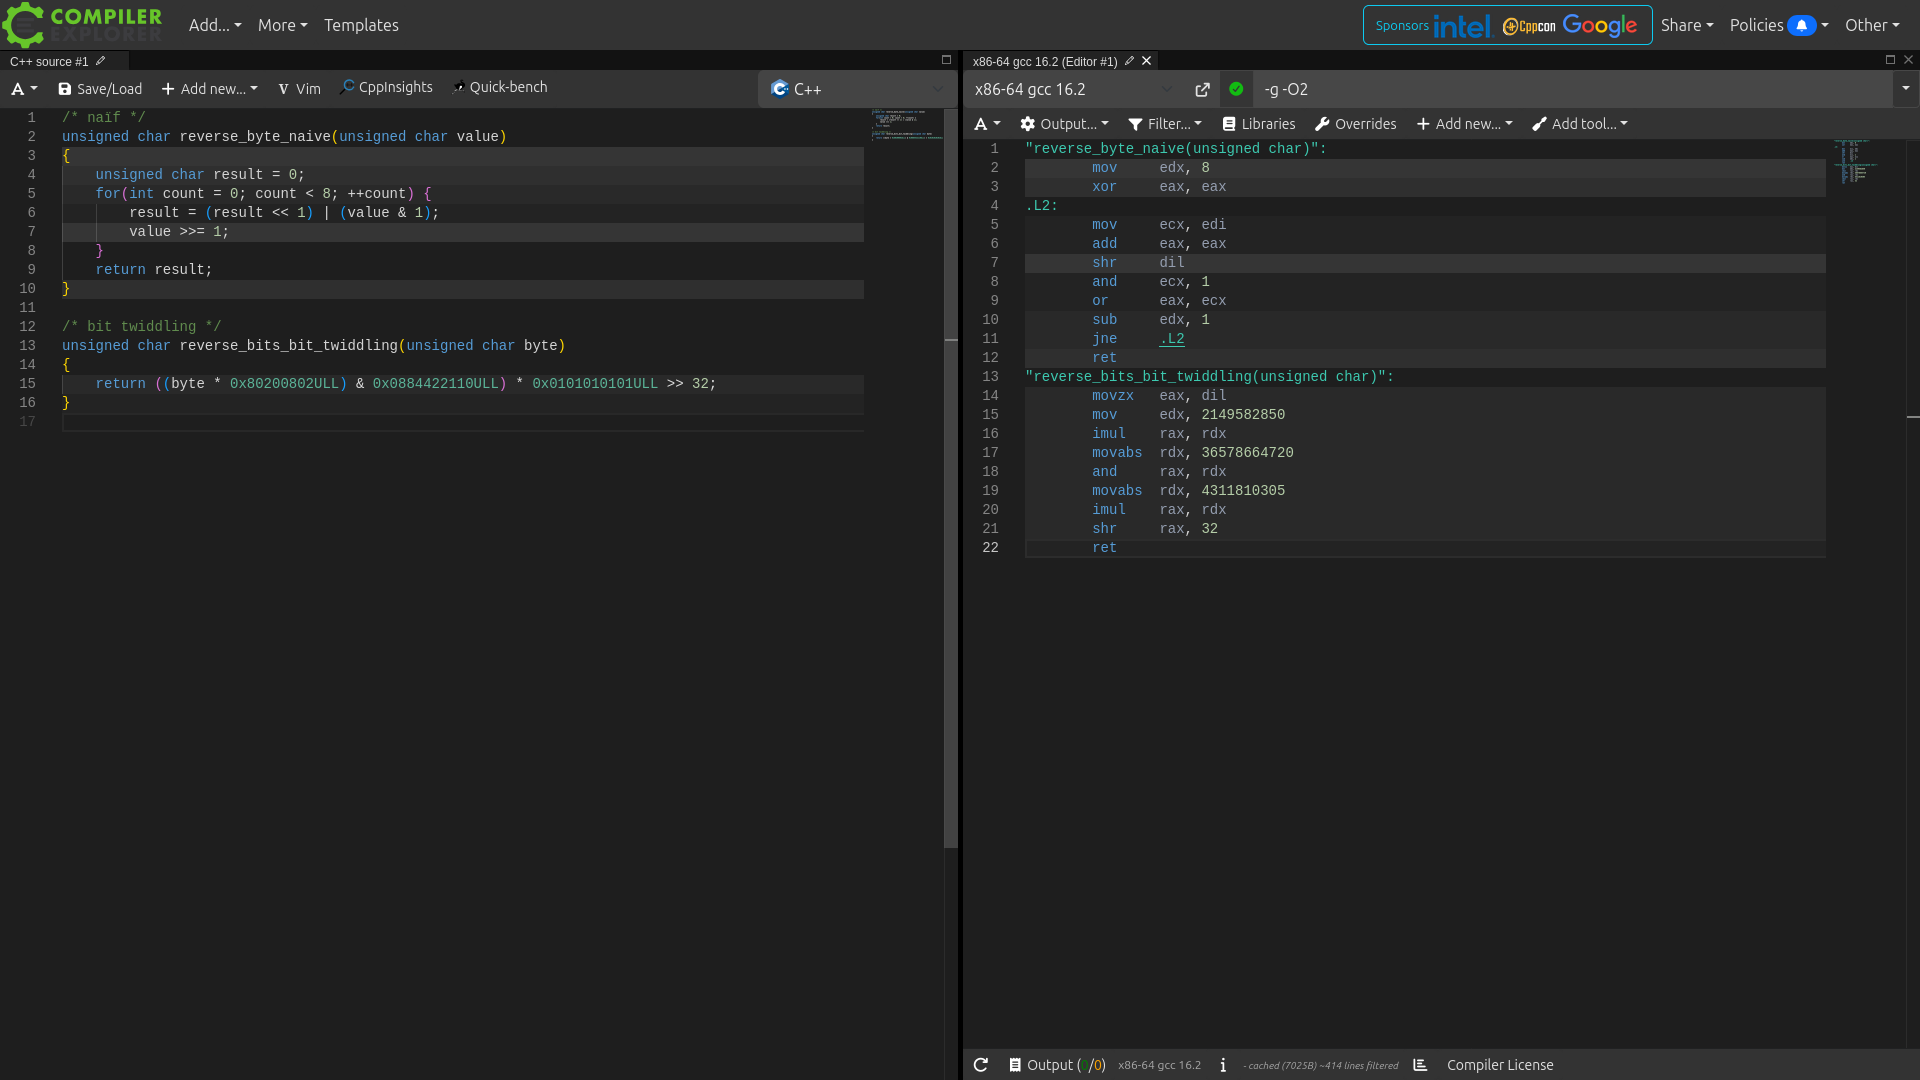
La version bit twiddling est toujours meilleure
(quel que soit le niveau d'optimisation)
INVERSER L'ORDRE DES BITS D'UN OCTET
Clang x86-64 avec optimisation
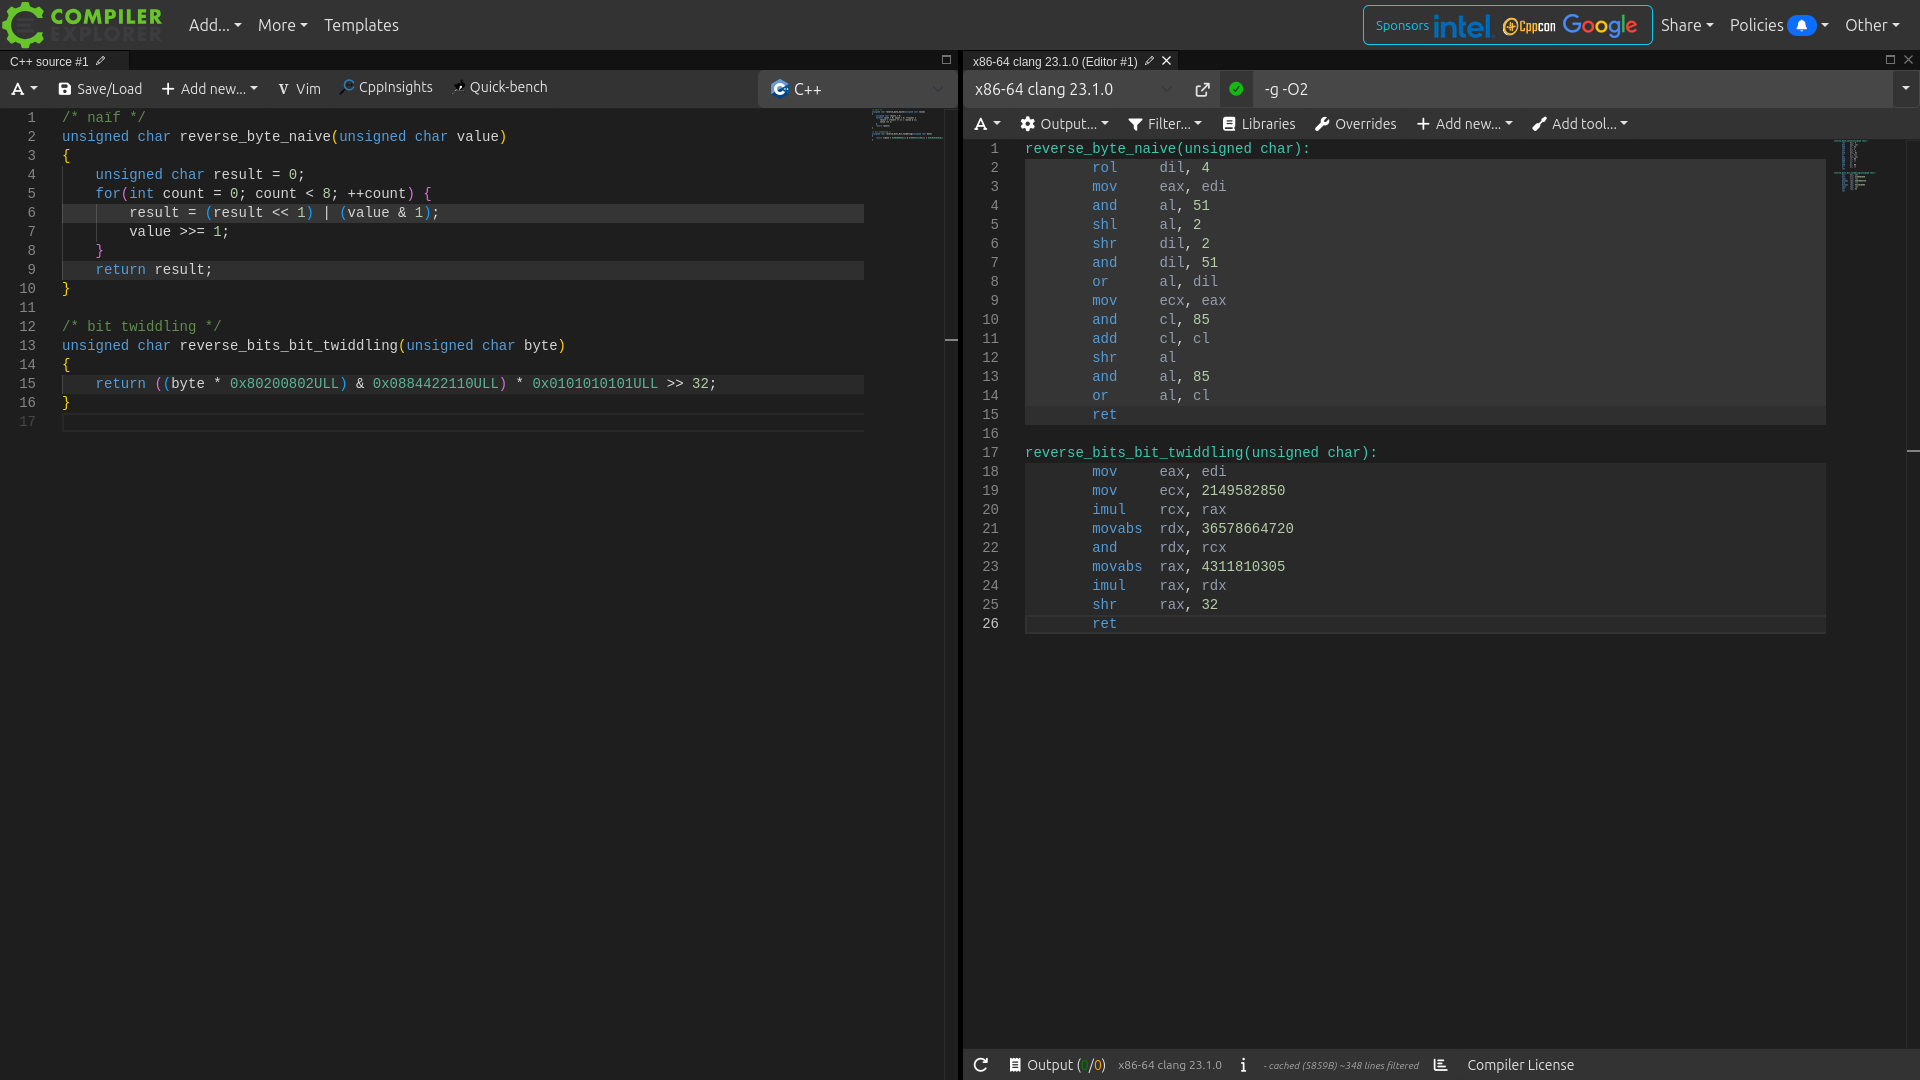
La version bit twiddling est toujours meilleure
(quel que soit le niveau d'optimisation)
EN RÉSUMÉ
Ce n'est pas une silver bullet
Aucune de ces techniques n'est universelle
Ce qui gagne sur x86-64 peut perdre sur AVR ou sur ARM, on l'a vu sur la valeur absolue
Le compilateur est souvent déjà au niveau
Sur des cas simples, il génère le même code que la version bit-twiddling
Toujours comparer et mesurer sur la cible visée
Compiler Explorer pour lire le code généré, micro-benchmark pour trancher
Et pourtant, elles sont partout
Dans la glibc, QEMU, le noyau Linux, etc ...
plusieurs variantes coexistent, choisies par architecture
DUFF'S DEVICE
Un morceau de code légendaire !
TOM DUFF
Un véritable chercheur, pas un bidouilleur
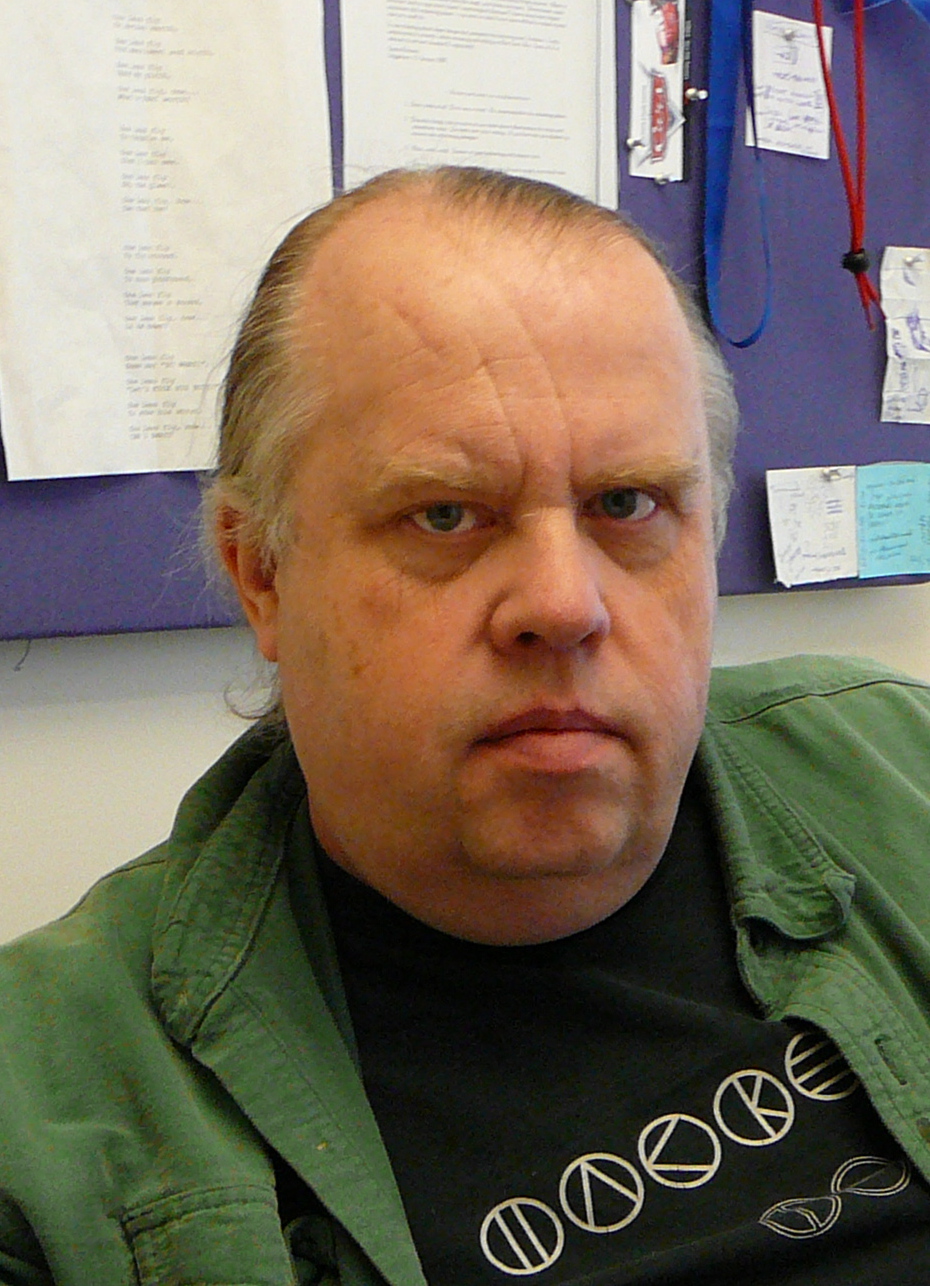
Chercheur et développeur canadien
Diplômé du New York Institute of Technology en 1974
A travaillé chez Lucasfilm LTD au début des années 80
Rendu 3D et compositing pour le studio d'effets spéciaux de George Lucas
A travaillé chez Bell Labs de 1984 à 1996
Recherche en computer graphics, les réseaux sans fil et l'OS Plan 9
A travaillé chez Pixar de 1996 à sa retraite en 2021
Recherche en modélisation et rendu 3D, compositing ...
LE COMPOSITING DE PORTER-DUFF
Un algorithme fondateur
Formalise les opérations de composition graphique
Canal alpha prémultiplié, opérateurs over/in/out/atop/xor, ...
Mis au point et testé en situation réelle chez Lucasfilm LTD
Par Thomas Porter & Tom Duff sur le film « Star Trek II : The Wrath of Khan » (1982)
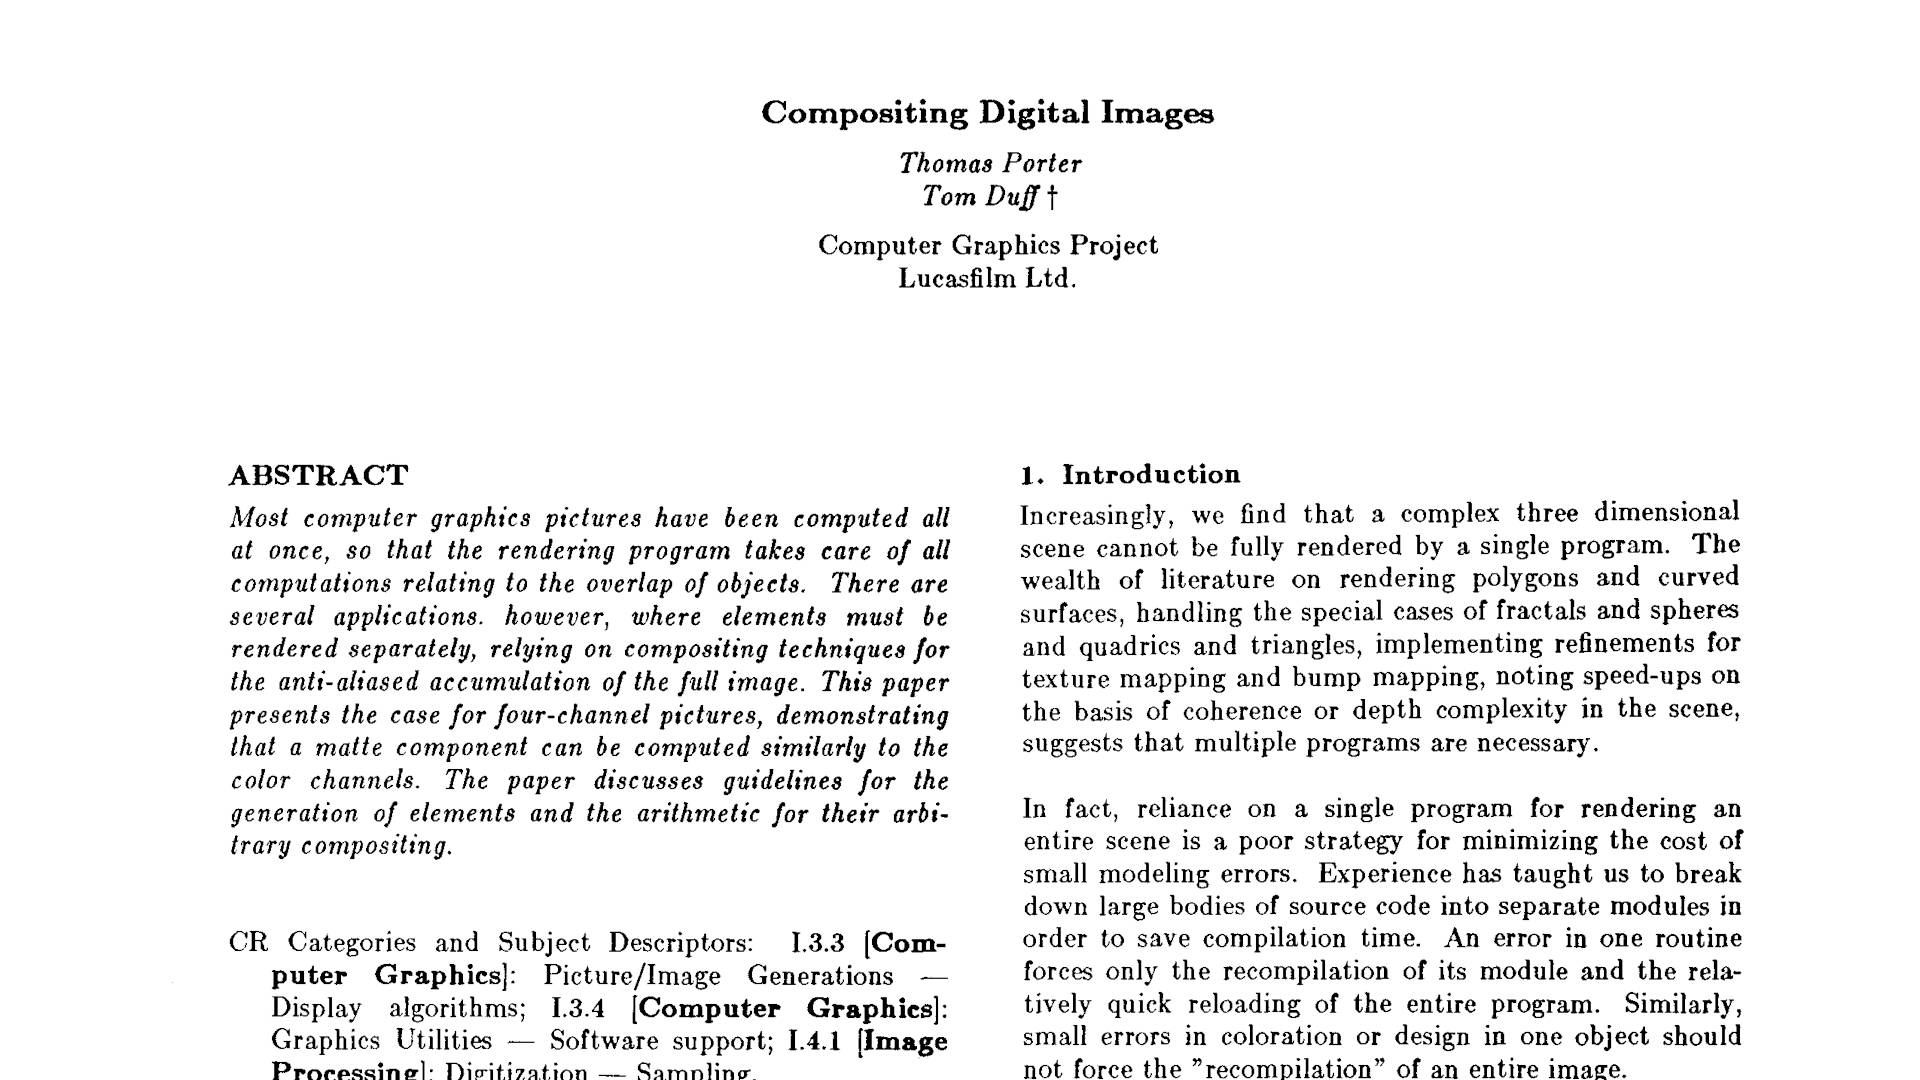
Un article incontournable écrit puis publié à SIGGRAPH en 1984
« Compositing Digital Images » par Thomas Porter & Tom Duff
Toujours utilisé aujourd'hui
Par les compositeurs Wayland ou X11/Xrender, moteurs de rendu 2D (Cairo, etc.), CSS (mix-blend-mode), ...
LE PROBLÈME D'ORIGINE
Envoyer des mots vers une carte graphique, et vite !
Chez Lucasfilm, Tom Duff écrit des pilotes de cartes graphiques
Des cartes Evans & Sutherland, le très haut de gamme de l'époque
Il doit envoyer très rapidement des flots d'entiers 16 bits
Vers un port de la carte mappé en mémoire (MMIO)
Particularité du MMIO : la destination ne s'incrémente pas
Chaque écriture part vers le même registre volatile, la carte avance son pointeur toute seule
LA MÉTHODE NAÏVE
Simple, lisible mais coûteuse
                                void send(volatile short* to, const short* from, int count)
                                {
                                    do {
                                        *to = *from++;
                                    } while(--count > 0);
                                }
Il y a un transfert par itération
MAIS AUSSI
Un décrément, un test et un branchement
Le nombre d'opérations double !
LA MÉTHODE DUFF
Déroulage de boucle extrême
                                void send(volatile short* to, const short* from, int count)
                                {
                                    int n = (count + 7) / 8;
                                    switch(count % 8) {
                                        case 0: do { *to = *from++;
                                        case 7:      *to = *from++;
                                        case 6:      *to = *from++;
                                        case 5:      *to = *from++;
                                        case 4:      *to = *from++;
                                        case 3:      *to = *from++;
                                        case 2:      *to = *from++;
                                        case 1:      *to = *from++;
                                                } while(--n > 0);
                                    }
                                }
CE CODE EST TOTALEMENT LÉGAL EN C et C++ 😱
LA MÉTHODE DUFF
Comment ça marche ?
La boucle est déroulée par groupe de 8
On effectue donc ((count + 7) / 8) tours de boucle
Le point d'entrée initial est choisi par le modulo
Le résultat du modulo est traité au premier tour permettant un alignement sur 8 pour les tours suivants
Un switch/case fall-through entremêlé avec un do/while
Les case servent de goto pour le tour initial permettant l'alignement sur 8
Les tours suivants copient 8 mots à la fois avec le do/while
Résultat : un seul test pour 8 transferts au lieu d'un test par transfert
On privilégie donc le pipeline du processeur et on divise par 8 le nombre de tests
ANALYSE PAS À PAS
Déroulons pour count = 11
                                void send(volatile short* to, const short* from, int count)
                                {
                                    int n = (count + 7) / 8;
                                    switch(count % 8) {
                                        case 0: do { *to = *from++;
                                        case 7:      *to = *from++;
                                        case 6:      *to = *from++;
                                        case 5:      *to = *from++;
                                        case 4:      *to = *from++;
                                        case 3:      *to = *from++;
                                        case 2:      *to = *from++;
                                        case 1:      *to = *from++;
                                                } while(--n > 0);
                                    }
                                }
LA VARIANTE DE DUFF
La même idée mais sans contorsion
                                void send(volatile short* to, const short* from, int count)
                                {
                                    while(count >= 8) {
                                        *to = *from++; *to = *from++;
                                        *to = *from++; *to = *from++;
                                        *to = *from++; *to = *from++;
                                        *to = *from++; *to = *from++;
                                        count -= 8;
                                    }
                                    switch(count & 7) {
                                        case 7: *to = *from++;
                                        case 6: *to = *from++;
                                        case 5: *to = *from++;
                                        case 4: *to = *from++;
                                        case 3: *to = *from++;
                                        case 2: *to = *from++;
                                        case 1: *to = *from++;
                                    }
                                }
GÉNÉRALISATION EN C++
Dérouler n'importe quoi
                                template <typename Callable>
                                void duff_loop(int count, Callable&& callable)
                                {
                                    int n = (count + 7) / 8;
                                    switch(count % 8) {
                                        case 0: do { callable();
                                        case 7:      callable();
                                        case 6:      callable();
                                        case 5:      callable();
                                        case 4:      callable();
                                        case 3:      callable();
                                        case 2:      callable();
                                        case 1:      callable();
                                                } while(--n > 0);
                                    }
                                }
L'IMPLÉMENTATION NAÏVE
Sous Compiler Explorer
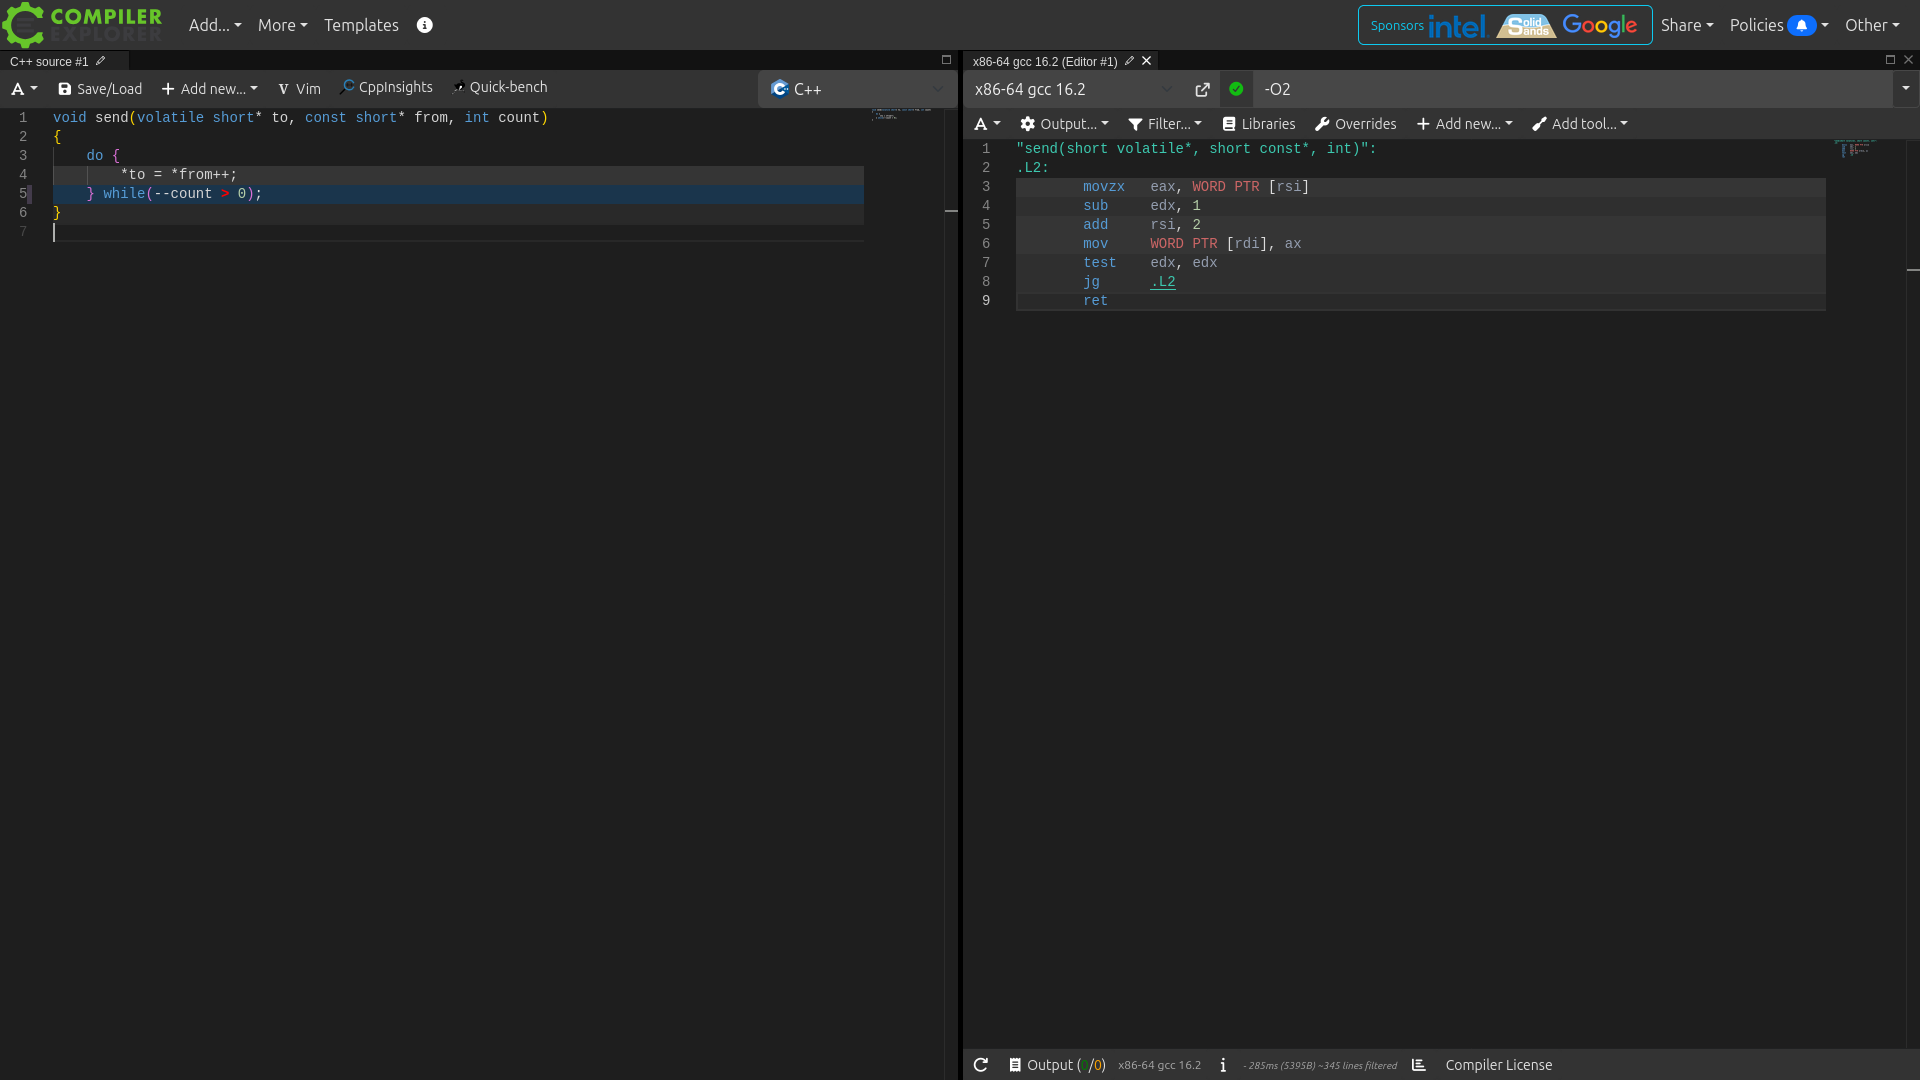
Code généré compact
mais toujours naïf
L'IMPLÉMENTATION DE DUFF
Sous Compiler Explorer
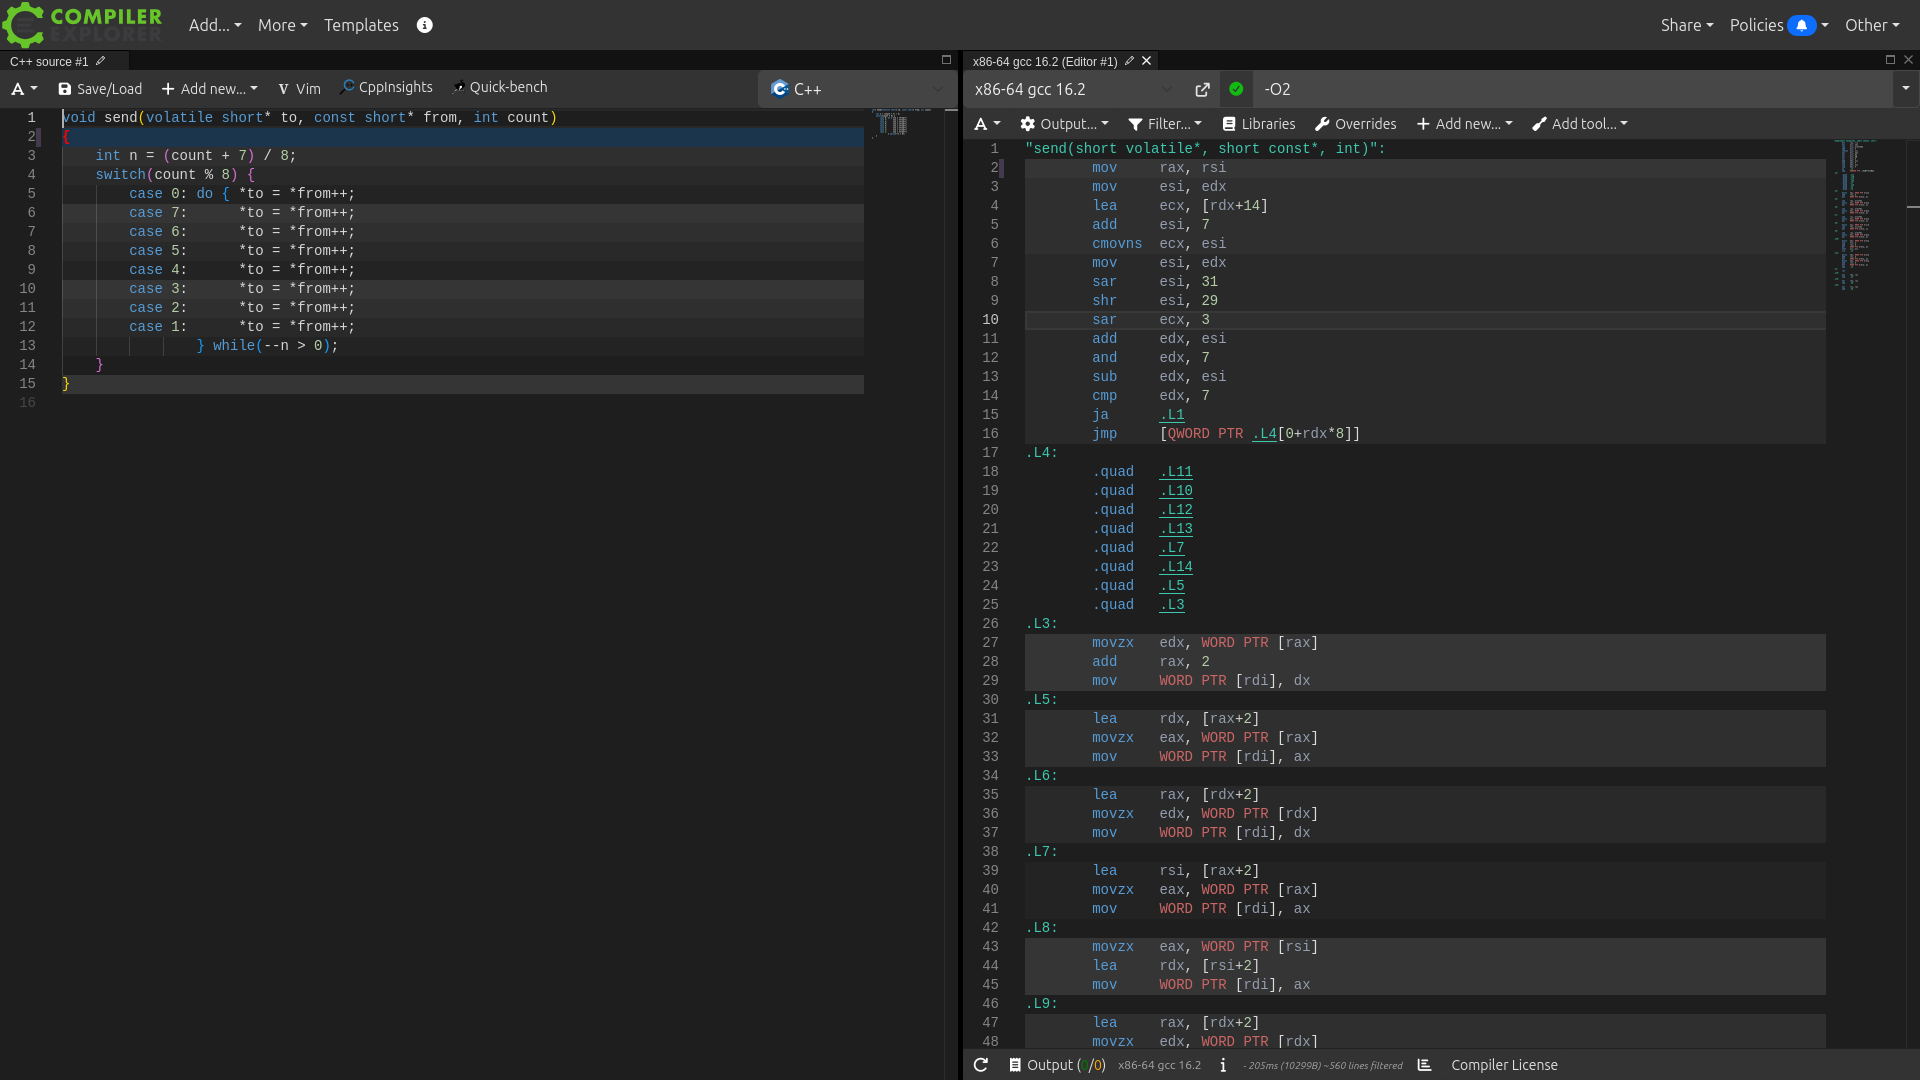
Code généré plus long
mais plus rapide
(le plus souvent)
L'IMPLÉMENTATION NAÏVE DÉROULÉE
Sous Compiler Explorer
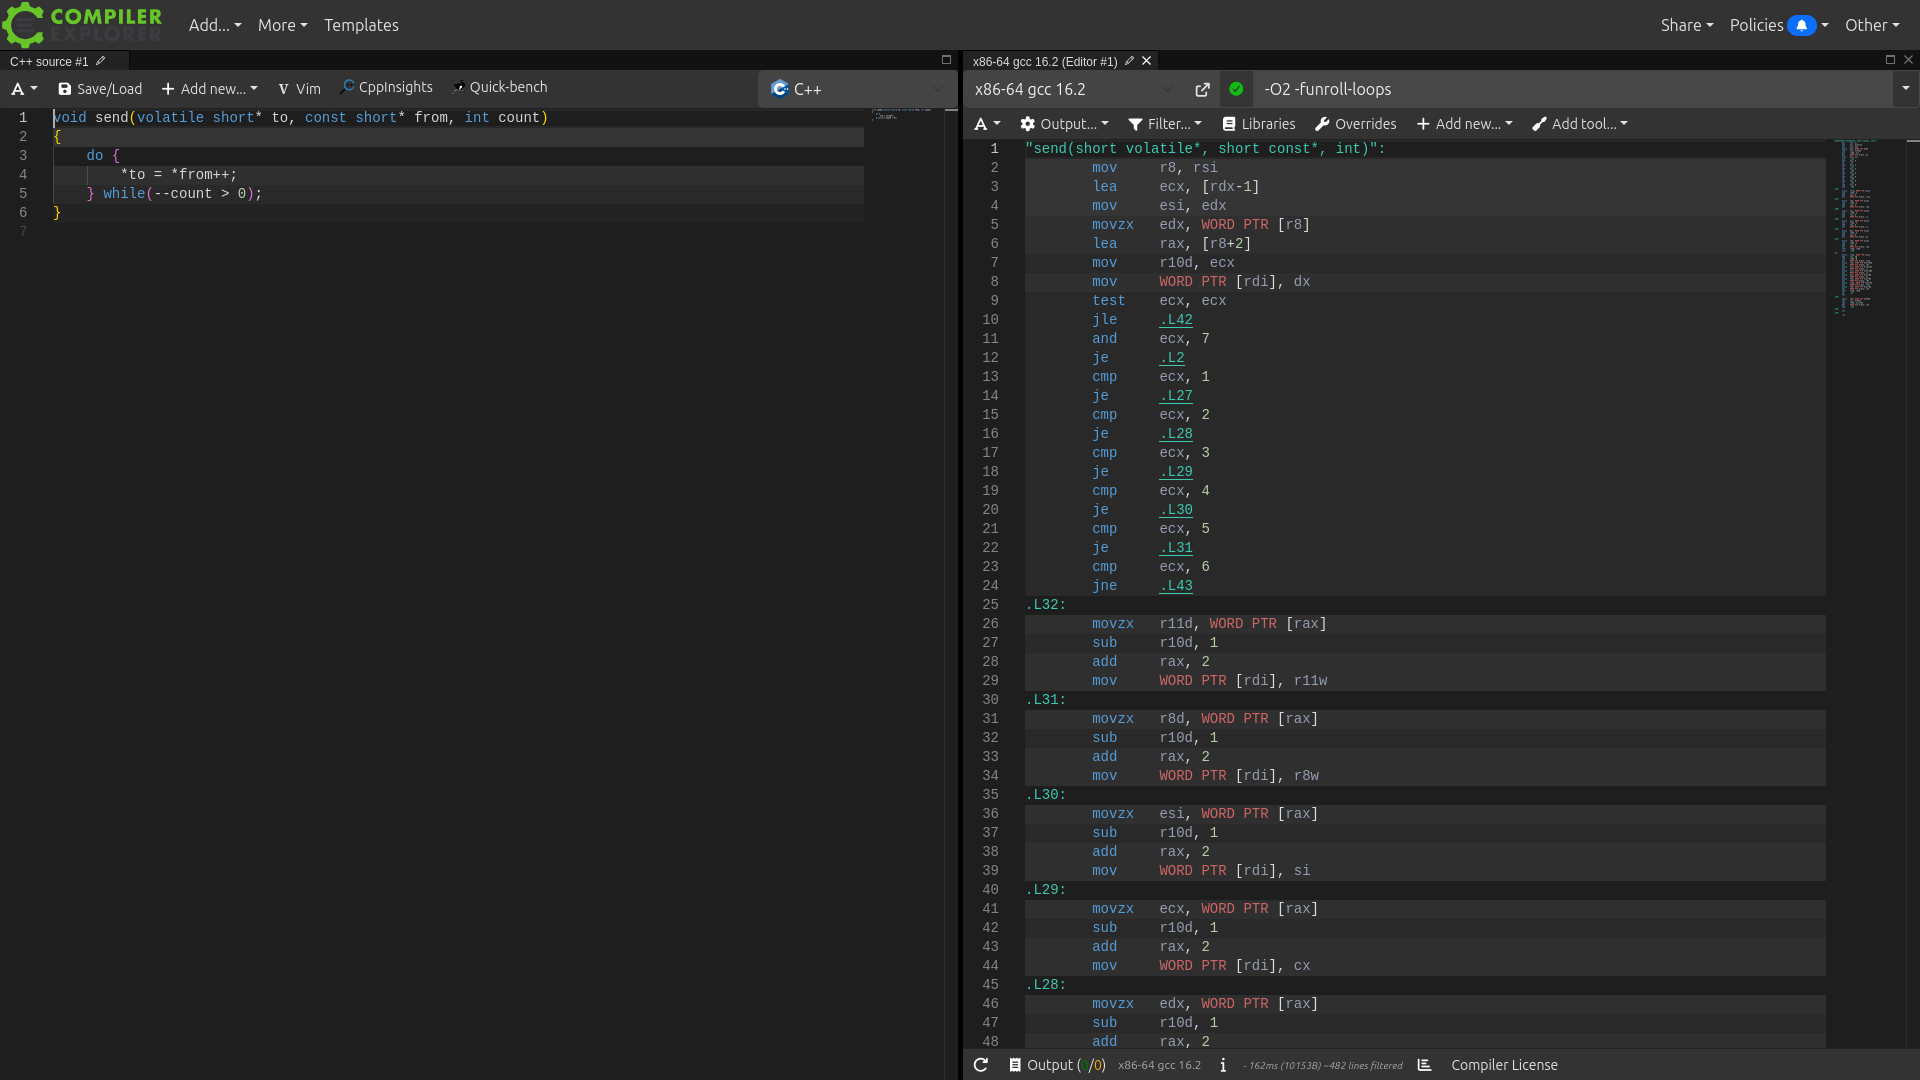
On retrouve le Duff's Device
ENCORE UTILISÉ DE NOS JOURS ?
Rarement, et pour certaines raisons
Construction fragile, difficile à maintenir, error prone
Interdite par la norme MISRA C (automobile, aéronautique)
Les compilateurs modernes savent dérouler tout seuls
-funroll-loops de GCC, heuristiques internes, ...
« Duff's Device in 2021 » (belaycpp)
Gain infinitésimal pour une copie mémoire, mais 68 % à 100 % quand le corps de boucle est complexe
Mais il reste des cas d'usage
Microcontrôleurs (AVR), émulateurs, boucles critiques où l'on veut contrôler le déroulage
MON AVIS SUR CE CODE
Effrayant et élégant tout à la fois
Un code effrayant en première lecture
Un switch/case et un do/while entremêlés, il fallait y penser
Un code élégant en seconde lecture
Il exploite les moindres recoins de la syntaxe du C pour un résultat compact et efficace
Selon vos projets, vous pourriez encore en avoir besoin
Projets sur microcontroleurs, chaîne de compilation ancienne, etc.
Vous pouvez encore en croiser dans du code
C'est qu'il y a (eu) un véritable enjeu d'optimisation derrière
POUR CONCLURE
Libérez votre esprit
DES TECHNIQUES POUSSÉES
A la limite du magiciel
Ces techniques ont littéralement des décennies
Et elles fascinent toujours autant
Comprendre pourquoi elles marchent
C'est comprendre comment nos machines fonctionnent vraiment
Ces techniques permettent des gains importants
Lorsque cela compte et avec des facteurs parfois très importants
CE QU'IL FAUT RETENIR
Quatre choses à emporter
Deux familles nées des mêmes contraintes
Détourner les mathématiques des nombres binaires, ou la grammaire du langage
Le compilateur fait souvent le travail à votre place
C'est lui qu'il faut interroger, jamais votre intuition
Elles restent pertinentes là où ça compte
Embarqué contraint, émulateurs, boucles critiques
Lisibilité et maintenabilité priment
Mesurer avant d'optimiser, toujours
QUAND UTILISER CES TECHNIQUES ?
La question à 100 balles
Uniquement dans du code chaud
Noyaux, traitement d'images, émulateurs, ...
Pas réservé aux langages de bas niveau
Les opérateurs bit à bit existent partout : Java, C#, JavaScript, Python, Go, Rust, PHP, ...
Les compilateurs modernes font parfois aussi bien voire mieux
Savoir lire ces constructions, et vérifier ce qui est généré
Toujours vérifier le code généré
Micro-benchmarker et ne garder que ce qui est mesuré
Exemples personnels : des émulateurs
Calcul des flags (carry, half-carry, signe), gains très importants sur des millions d'itérations par seconde
POUR ALLER PLUS LOIN
Bit Twiddling Hacks
POUR ALLER PLUS LOIN
Hacker's Delight
POUR ALLER PLUS LOIN
xchg rax,rax
A PROPOS DE MOI
Un peu de personal branding
OLIVIER PONCET
Retrouvez-moi sur les réseaux
 |
||
| @ponceto91 | emaxilde.net | |
| @ponceto91 | github.com/ponceto/ | |
| @ponceto91 | gitlab.com/ponceto/ | |
| @ponceto91 | bitbucket.org/ponceto/ |
MERCI
Des questions ?